
DeepSeek V4.1 Flash es un modelo multimodal Mixture of Experts, o MoE, orientado a razonamiento, programación, agentes y análisis de imágenes. La versión vigente al 10 de noviembre de 2026 es DeepSeek-V4.1-Flash-1017, disponible en la web, la aplicación y la API de DeepSeek.
En la API oficial no debes enviar el nombre completo del checkpoint. El identificador correcto es deepseek-flash. El modelo acepta texto e imágenes, genera texto, ofrece hasta un millón de tokens de contexto y admite Thinking Mode, Tool Calls, salida JSON y formatos compatibles con OpenAI y Anthropic.
Información verificada el 10 de noviembre de 2026.
Ficha técnica de DeepSeek V4.1 Flash
| Característica | Dato verificado |
|---|---|
| Versión actual alojada por DeepSeek | DeepSeek-V4.1-Flash-1017 |
| Identificador de la API oficial | deepseek-flash |
| Lanzamiento de V4.1 Flash | 10 de septiembre de 2026 |
| Actualización 1017 | 17 de octubre de 2026 |
| Entradas | Texto e imágenes |
| Salidas | Texto |
| Ventana de contexto | 1,048,576 tokens, contando entrada y salida |
| Salida máxima | 393,216 tokens, equivalentes a 384K |
| Thinking Mode | Compatible y activado de forma predeterminada |
| Niveles de esfuerzo en la API | low, high y max; none desactiva el razonamiento |
| Funciones | Tool Calls, JSON Output, Responses API, Anthropic API, Vision y completado FIM beta |
| Límite de concurrencia oficial | 2,500 solicitudes simultáneas por cuenta |
| Pesos publicados | Repositorio oficial bajo licencia MIT |
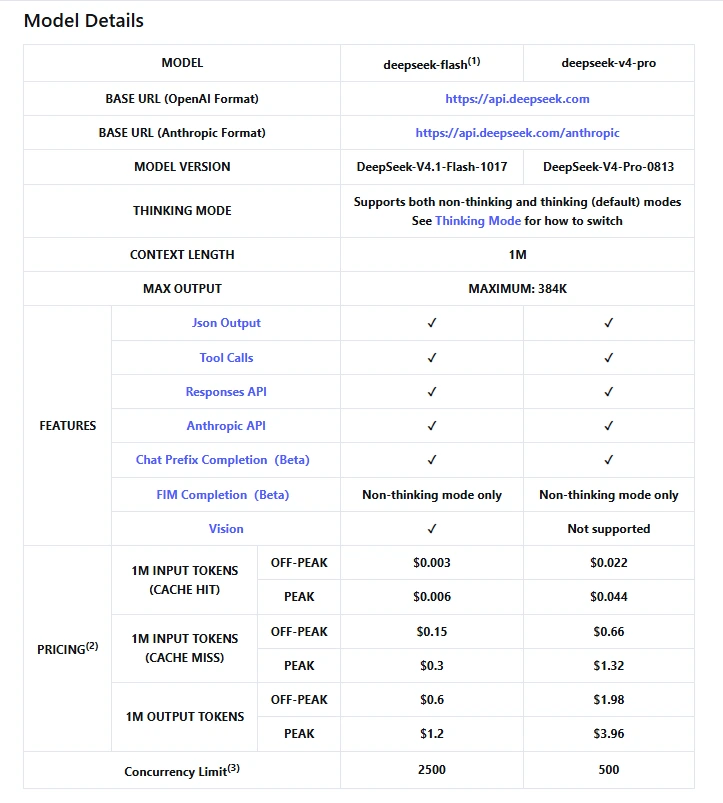
El límite de concurrencia se calcula a nivel de cuenta, no por cada clave API. Superarlo puede producir un error HTTP 429. DeepSeek permite solicitar una ampliación de capacidad cuando el proyecto necesita un volumen superior.
¿Cuál es la versión actual de DeepSeek V4.1 Flash?
DeepSeek presentó la versión inicial de V4.1 Flash el 10 de septiembre de 2026. El 17 de octubre publicó DeepSeek-V4.1-Flash-1017, una actualización menor en el nombre, pero con mejoras publicadas en razonamiento, programación, tareas con agentes y benchmarks visuales.
La empresa también actualizó el modelo utilizado en su sitio web y su aplicación. Para acceder a la versión más reciente desde la API, debes mantener el identificador deepseek-flash; no es necesario cambiarlo a DeepSeek-V4.1-Flash-1017.
| Nombre | Qué representa | Cómo debe utilizarse |
|---|---|---|
| DeepSeek V4.1 Flash | Nombre de la familia o versión general | Útil para describir el modelo en un artículo o interfaz |
| DeepSeek-V4.1-Flash-1017 | Checkpoint y versión actualmente alojada | Úsalo al hablar de resultados, pesos o versión concreta |
deepseek-flash | Identificador de la API oficial de DeepSeek | Envíalo en el campo model |
deepseek-v4-flash | Identificador heredado | Todavía se acepta temporalmente, pero redirige al modelo actual |
deepseek-v4-flash-vision-exp | Identificador heredado del modelo visual experimental | El modelo original está retirado y sus solicitudes se sirven con V4.1 Flash |
No utilices el identificador de Google Cloud, Alibaba Cloud u otro proveedor externo como si fuera el de DeepSeek. Cada plataforma puede aplicar su propio nombre, precio, disponibilidad, límite de salida y etapa de lanzamiento.
Qué cambió en la actualización 1017
DeepSeek describe 1017 como una actualización enfocada en mejorar el desarrollo de proyectos de principio a fin. Según la ficha oficial, utiliza aprendizaje por refuerzo con autoevaluación para avanzar desde una petición inicial hasta tareas más extensas de programación, construcción de interfaces y creación de proyectos.
- Mejores resultados publicados en razonamiento, programación, agentes y visión.
- Menor duración de las tareas en los agentes evaluados por DeepSeek.
- Respuestas más cortas que la versión inicial en los escenarios medidos.
- Optimización para DeepSeek Harness, CodeBuddy, WorkBuddy y otras herramientas.
- Disponibilidad simultánea en la web, la aplicación, la API y los repositorios de pesos.
- El mismo identificador de API y las mismas tarifas de V4.1 Flash.
Estas mejoras no significan que 1017 vaya a ser superior en todas las tareas. Un proyecto real debe evaluar calidad, duración, consumo de tokens, llamadas a herramientas y regresiones con sus propios datos.
Arquitectura: qué significan 552B, 763B, 8B y 16B
Los números publicados para DeepSeek V4.1 Flash miden partes diferentes del modelo. No son cuatro formas intercambiables de expresar su tamaño.
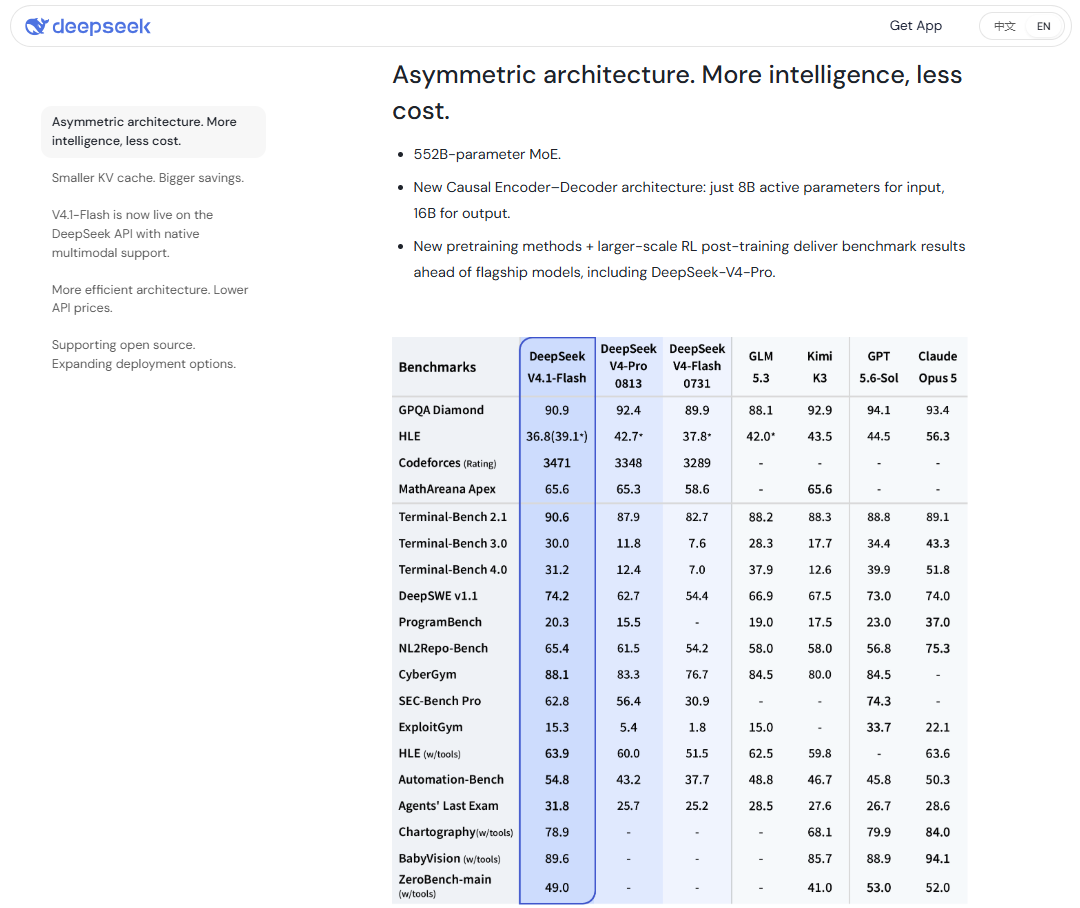
| Cifra | Qué significa |
|---|---|
| 552B | Parámetros del backbone descrito por DeepSeek |
| 8B | Parámetros activos durante el procesamiento de la entrada o prefill |
| 16B | Parámetros activos durante la generación de la salida o decode |
| 763B | Tamaño del modelo mostrado por Hugging Face para el repositorio completo del checkpoint 1017 |
Por tanto, describirlo simplemente como un modelo de 8B o 16B sería incorrecto. Esas cifras indican cuántos parámetros intervienen activamente en determinadas fases de la inferencia, no el tamaño completo de la arquitectura ni los recursos necesarios para alojar todos sus pesos.
La documentación pública utiliza 552B para el backbone y la interfaz de Hugging Face muestra 763B para el modelo almacenado. Como las fuentes no presentan una equivalencia única y directa entre ambos campos, conviene conservar sus nombres originales en lugar de inventar una explicación numérica.
Cómo funciona el modelo MoE
Mixture of Experts significa que el modelo dispone de numerosos bloques especializados, pero no activa todos para cada token. La ficha técnica describe un experto compartido y 384 expertos enrutados por capa MoE, de los cuales se activan seis por token.
Esta selección busca reducir el cálculo necesario frente a una arquitectura densa del mismo tamaño total. Sin embargo, menos parámetros activos no implica que los pesos completos ocupen poco espacio ni que el modelo pueda ejecutarse cómodamente en una computadora convencional.
Qué aporta Causal Encoder–Decoder
DeepSeek V4.1 Flash utiliza una arquitectura Causal Encoder–Decoder de 40 capas: 20 pertenecen al encoder causal y 20 al decoder. Durante el prefill, el modelo procesa la entrada; durante el decode, genera la respuesta token por token.
El decoder obtiene su KV cache global a partir de los estados finales del encoder, en vez de mantener una caché independiente derivada de cada capa del decoder. DeepSeek afirma que, frente a la generación anterior, esto reduce las necesidades de KV cache a una cuarta parte en HBM y a una octava parte en almacenamiento SSD.
La reducción se refiere específicamente a KV cache. No significa que el consumo total de memoria, la latencia o el costo final vayan a reducirse en la misma proporción en todos los proveedores, longitudes de contexto y tamaños de lote.
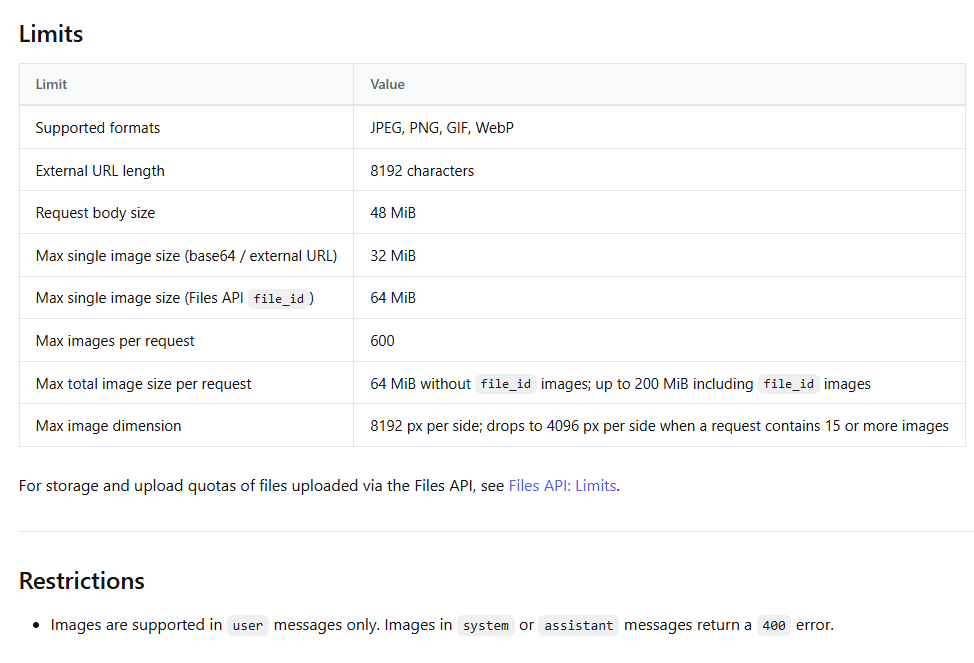
Visión nativa: qué imágenes puede analizar
DeepSeek V4.1 Flash admite entradas combinadas de texto e imágenes y produce texto como salida. Puede describir una imagen, leer texto de una captura, interpretar elementos de una interfaz o analizar un gráfico, pero no es un generador de imágenes.
| Elemento | Límite documentado en la API |
|---|---|
| Formatos | JPEG, PNG, GIF y WebP |
| Imagen enviada mediante base64 o URL | Hasta 32 MiB por imagen |
| Imagen mediante Files API | Hasta 64 MiB por archivo |
| Cuerpo de una solicitud inline | Hasta 48 MiB |
| Número máximo de imágenes | 600 por solicitud |
| Tamaño total con archivos referenciados | Hasta 200 MiB |
| Consumo máximo tras el redimensionamiento | Hasta 1,024 tokens por imagen |
Las imágenes pueden enviarse mediante una URL externa, una data URL en base64 o un file_id de Files API. Esta última API está documentada para imágenes; no debe presentarse como un sistema general para subir PDF, documentos de Word o cualquier tipo de archivo.
La opción de detalle low reduce la imagen a 512 × 512 antes del procesamiento. Puede ahorrar tiempo y tokens cuando los detalles pequeños no son importantes. Para OCR, tablas densas o capturas con texto pequeño, conviene comparar low con el tamaño original.
Contexto de un millón de tokens y salida de 384K
La API publica una ventana de contexto de 1,048,576 tokens. Esta capacidad incluye la suma de la entrada y la salida, no un millón de tokens de entrada más otros 384K de respuesta.
El límite máximo de generación es de 393,216 tokens, o 384K. Los valores predeterminados son menores:
- 8K tokens en modo sin razonamiento.
- 64K tokens en Thinking Mode con el esfuerzo predeterminado.
- 128K tokens cuando se utiliza
reasoning_effort="max". - Hasta 384K cuando el desarrollador establece expresamente un valor mayor permitido.
Una ventana extensa permite trabajar con repositorios, historiales, documentos y resultados de herramientas más grandes. No garantiza que el modelo recuerde cada dato con la misma precisión ni que convenga llenar siempre todo el contexto.
Las imágenes, mensajes anteriores, respuestas de herramientas y tokens de razonamiento también consumen capacidad. Para aplicaciones reales, mide la recuperación de información en el inicio, el centro y el final de tus entradas largas.
Thinking Mode, Tool Calls y funciones de la API
Thinking Mode está activado de manera predeterminada con esfuerzo high. En la API alojada puedes usar low, high o max; el valor none desactiva el razonamiento.
El checkpoint publicado admite un control numérico continuo de 1 a 100. Ese ajuste local no debe confundirse con los niveles discretos expuestos por la API oficial.
| Función | Estado y uso |
|---|---|
| Thinking Mode | Activado de forma predeterminada; permite controlar el esfuerzo |
| Tool Calls | El modelo propone argumentos para funciones; tu aplicación ejecuta la herramienta |
| JSON Output | Permite solicitar una respuesta JSON válida cuando el prompt también lo exige |
| Responses API | Formato compatible con la API Responses de OpenAI |
| Anthropic API | Endpoint compatible disponible en /anthropic |
| Chat Prefix Completion | Función beta que completa un prefijo del asistente |
| FIM | Función beta para completar entre un prefijo y un sufijo; hasta 4K de salida |
| Vision | Texto e imágenes como entrada; texto como salida |
FIM funciona únicamente en modo sin razonamiento y requiere la base URL beta. Está pensado para autocompletado y tareas como insertar código entre una parte inicial y otra final.
En Tool Calls, DeepSeek no ejecuta por sí mismo una función, una consulta, un comando ni una compra. Devuelve el nombre de la herramienta y sus argumentos; el software del desarrollador debe validar esos datos, ejecutar la acción y devolver el resultado.
Benchmarks de DeepSeek-V4.1-Flash-1017
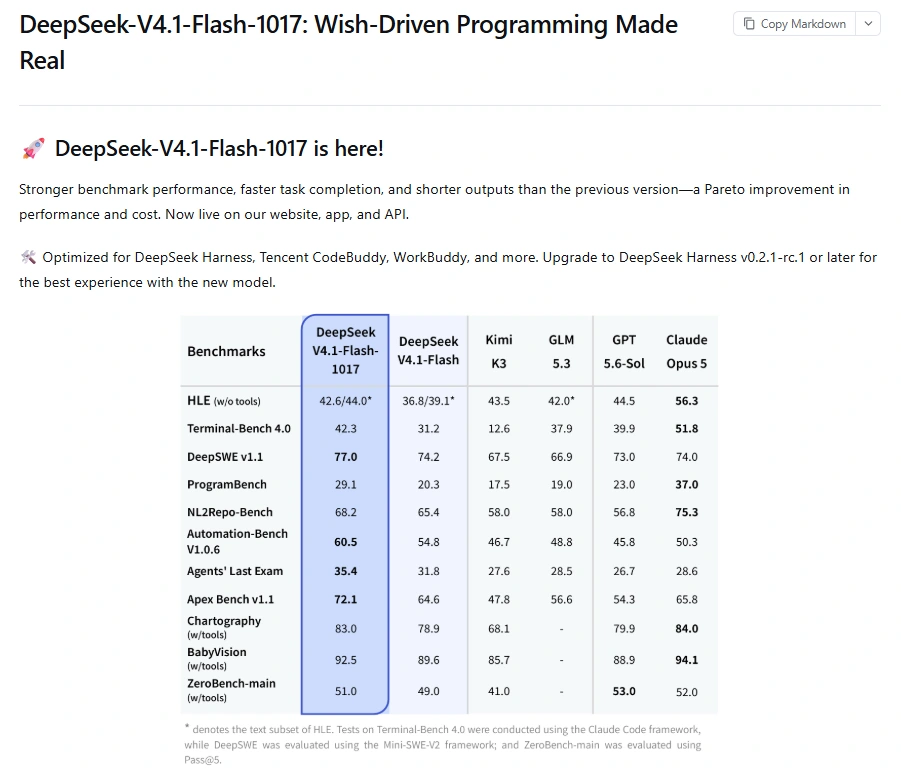
DeepSeek publicó mejoras de 1017 frente a la primera versión de V4.1 Flash. Los siguientes valores proceden de la ficha oficial del modelo, no de una evaluación independiente realizada para este artículo.
| Benchmark | V4.1 Flash inicial | V4.1 Flash 1017 |
|---|---|---|
| HLE sin herramientas | 36.8 | 42.6 |
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| ProgramBench | 20.3 | 29.1 |
| NL2Repo-Bench | 65.4 | 68.2 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 |
| Agents’ Last Exam | 31.8 | 35.4 |
| BabyVision con herramientas | 89.6 | 92.5 |
Terminal-Bench 4.0 se evaluó con el harness de Claude Code y DeepSWE v1.1 con Mini-SWE-V2. El resultado adicional de 44.0 en HLE corresponde únicamente al subconjunto de texto. Cambiar el harness, el esfuerzo de razonamiento, el contexto o las herramientas puede modificar el resultado.
Estos benchmarks sugieren una mejora, pero no sustituyen una prueba con tus propios tickets, repositorios, imágenes y herramientas. Antes de migrar, define una métrica de aceptación y compara calidad, costo total, duración y porcentaje de tareas completadas.
DeepSeek V4.1 Flash vs V4 Flash y V4 Pro
| Característica | V4.1 Flash 1017 | V4 Flash | V4 Pro 0813 |
|---|---|---|---|
| Estado en la API oficial | Disponible | Retirado | Disponible |
| ID actual | deepseek-flash | Los ID antiguos redirigen temporalmente | deepseek-v4-pro |
| Visión | Sí | No como servicio independiente actual | No |
| Contexto | 1M | Sin servicio independiente actual | 1M |
| Salida máxima | 384K | Sin servicio independiente actual | 384K |
| Thinking y Non-Thinking | Sí | Sin servicio independiente actual | Sí |
| Tool Calls | Sí | Sin servicio independiente actual | Sí |
| Concurrencia | 2,500 | No aplica | 500 |
| Precio de entrada con cache miss en hora valle | US$0.15 por 1M | No aplica | US$0.66 por 1M |
| Precio de salida en hora valle | US$0.60 por 1M | No aplica | US$1.98 por 1M |
El anuncio original de V4.1 Flash indicó que DeepSeek retiraría progresivamente V4 Pro. Sin embargo, el registro de cambios publicado posteriormente aclaró que el servicio de V4 Pro continuaría disponible debido a la demanda de los usuarios. La tabla actual de precios todavía muestra deepseek-v4-pro.
Para una integración nueva que necesite visión, mayor concurrencia o tarifas inferiores, V4.1 Flash es el punto de partida más directo. Si ya utilizas V4 Pro, no migres basándote únicamente en el nombre o en un benchmark: compara ambos con las tareas y criterios de tu aplicación.
Precio de DeepSeek V4.1 Flash
La API se factura por los tokens de entrada y salida. El precio de la entrada cambia según haya un cache hit, cuando parte del prefijo reutilizado se encuentra en caché, o un cache miss, cuando debe procesarse como entrada nueva.
| Concepto por 1M de tokens | Hora valle | Hora punta |
|---|---|---|
| Entrada con cache hit | US$0.003 | US$0.006 |
| Entrada con cache miss | US$0.15 | US$0.30 |
| Salida | US$0.60 | US$1.20 |
Las horas punta son de 01:00 a 04:00 UTC y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los días festivos oficiales de China. El resto del tiempo, incluidos los fines de semana y esos días festivos completos, se factura como hora valle.
Ejemplo de costo
Supón una solicitud con 800,000 tokens de entrada y 100,000 tokens de salida en total: 900,000 tokens, dentro de la ventana de 1,048,576. Para el cálculo, la entrada equivale a 0.8 millones de tokens y la salida a 0.1 millones:
- Cache miss en hora valle: (0.8 × US$0.15) + (0.1 × US$0.60) = US$0.18.
- Cache miss en hora punta: (0.8 × US$0.30) + (0.1 × US$1.20) = US$0.36.
- Cache hit en hora valle: (0.8 × US$0.003) + (0.1 × US$0.60) = US$0.0624.
- Cache hit en hora punta: (0.8 × US$0.006) + (0.1 × US$1.20) = US$0.1248.
El cálculo es ilustrativo. La factura real depende de los tokens devueltos por la API, las imágenes procesadas, el porcentaje de entrada que acierte la caché y el horario de cada solicitud.
Search y Fetch son servicios separados del modelo. Cada endpoint cuesta US$0.75 por 1,000 solicitudes completadas correctamente, por lo que una aplicación con agentes debe sumar ese consumo al precio de los tokens.
Cómo usar DeepSeek V4.1 Flash mediante API
La API oficial utiliza un formato compatible con el SDK de OpenAI. Necesitas una clave creada en la plataforma de DeepSeek y saldo disponible.
Instala o actualiza el SDK:
pip install --upgrade openaiGuarda la clave en la variable de entorno DEEPSEEK_API_KEY y utiliza el siguiente ejemplo:
import os
import sys

from openai import OpenAI


api_key = os.getenv("DEEPSEEK_API_KEY")

if not api_key:
    sys.exit(
        "Define la variable DEEPSEEK_API_KEY antes de ejecutar el script."
    )

client = OpenAI(
    api_key=api_key,
    base_url="https://api.deepseek.com",
)

try:
    response = client.chat.completions.create(
        model="deepseek-flash",
        messages=[
            {
                "role": "system",
                "content": (
                    "Responde con precisión y señala cualquier dato "
                    "que no puedas verificar."
                ),
            },
            {
                "role": "user",
                "content": (
                    "Explica en español qué diferencia existe entre "
                    "una ventana de contexto y el límite de salida."
                ),
            },
        ],
        reasoning_effort="high",
        extra_body={
            "thinking": {
                "type": "enabled"
            }
        },
        max_tokens=800,
        stream=False,
    )

    print(response.choices[0].message.content)

except Exception as exc:
    print(f"Error al llamar a la API de DeepSeek: {exc}")
El ejemplo utiliza el endpoint oficial, el identificador vigente y Thinking Mode. Está basado en la documentación actual, pero debes ejecutarlo en tu entorno y adaptar el manejo de errores, reintentos, tiempos de espera y registros antes de utilizarlo en producción.
La API es stateless: no conserva una conversación activa para completar automáticamente la siguiente solicitud. Tu aplicación debe reenviar el historial que necesite. Esto también significa que un historial largo vuelve a consumir contexto y puede generar nuevos costos de entrada.
¿Se puede descargar y ejecutar localmente?
Sí. DeepSeek publicó los pesos de DeepSeek-V4.1-Flash-1017 en Hugging Face y ModelScope. El repositorio y los pesos oficiales se distribuyen bajo licencia MIT.
Descargar los pesos no equivale a disponer de un servicio local funcional. La ficha de Hugging Face muestra un tamaño de modelo de 763B y el repositorio proporciona referencias para vLLM, SGLang, conversión de pesos, codificación del prompt y ejecución mínima.
DeepSeek no publica en esa ficha un requisito único de GPU, RAM o almacenamiento que sirva para cualquier configuración. La necesidad real cambia con la precisión, la cuantización, el contexto, el batch size, el runtime y el nivel de offloading.
- No asumas que funcionará en cualquier laptop por existir una cuantización.
- Comprueba si la cuantización es oficial o de un tercero.
- Verifica el soporte de visión, Tool Calls y el formato de prompt.
- Prueba la calidad después de reducir la precisión.
- Mide memoria, velocidad y estabilidad con la longitud de contexto que realmente necesitas.
- Revisa por separado la licencia del modelo, el runtime y cualquier componente externo.
La licencia de los pesos no sustituye los términos de la API alojada. Si llamas a DeepSeek o a otro proveedor mediante Internet, también se aplican las condiciones, tarifas y políticas de esa plataforma.
Para qué casos puede servir DeepSeek V4.1 Flash
| Caso de uso | Por qué puede encajar | Qué debes probar |
|---|---|---|
| Agentes de programación | Contexto largo, razonamiento, Tool Calls y resultados publicados en repositorios | Porcentaje de tareas resueltas, regresiones, costo y comandos ejecutados |
| Análisis de interfaces e imágenes | Entrada visual nativa junto con texto | OCR, texto pequeño, gráficos, posiciones y capturas reales |
| RAG y documentos extensos | Ventana de contexto de hasta 1M | Recuperación en diferentes posiciones, citas, latencia y costo |
| Automatización con herramientas | Thinking Mode y llamadas de función | Argumentos válidos, tasa de llamadas correctas y manejo de errores |
| Generación estructurada | JSON Output y esquemas controlados por la aplicación | Validez del JSON, campos ausentes y respuestas truncadas |
| Autocompletado de código | FIM y Chat Prefix Completion | Compatibilidad del lenguaje, versiones y límite beta de salida |
| Procesamiento de alto volumen | Concurrencia oficial de hasta 2,500 y precio reducido | Throughput, errores 429, colas, reintentos y gasto por horario |
No existe en la documentación consultada un porcentaje oficial que mida específicamente la calidad de V4.1 Flash en español. Antes de utilizarlo con clientes latinoamericanos, crea un conjunto de pruebas con tu vocabulario, instrucciones, formatos y criterios de tono.
Checklist antes de utilizarlo en producción
- Define tareas reales y resultados aceptables.
- Fija el identificador
deepseek-flashy registra elsystem_fingerprintcuando corresponda. - Prueba Thinking Mode con esfuerzo bajo, alto y máximo.
- Mide entrada, razonamiento, salida y porcentaje de cache hit.
- Evalúa la recuperación en documentos largos.
- Valida imágenes pequeñas, densas, borrosas y con texto.
- Comprueba cada argumento antes de ejecutar una Tool Call.
- Aplica límites a comandos, archivos, gastos y acciones irreversibles.
- Compara la tarifa punta y valle con el horario de tu carga.
- Repite las pruebas después de una actualización del modelo.
- Evalúa la calidad en español con datos propios.
- Revisa privacidad, residencia de datos y permisos antes de enviar información real.
Limitaciones y privacidad
- Un contexto de un millón de tokens no garantiza una recuperación perfecta de todos los detalles.
- El modelo puede inventar datos, bibliotecas, funciones, citas o resultados plausibles.
- Los benchmarks publicados por DeepSeek dependen de sus configuraciones y harnesses.
- La visión admite imágenes como entrada, pero no genera imágenes como salida.
- Tool Calls no ejecuta herramientas sin el software y los permisos de tu aplicación.
- FIM y Chat Prefix Completion siguen marcadas como funciones beta.
- Los identificadores heredados pueden cambiar o dejar de redirigir en el futuro.
- Alojar el checkpoint completo requiere una evaluación seria de infraestructura.
La política de privacidad de DeepSeek indica que sus servicios pueden recopilar prompts, archivos, fotografías, historial del chat y otros contenidos proporcionados por el usuario. También ofrece una opción para excluir el uso de datos en el entrenamiento u optimización de sus tecnologías.
La documentación de Responses API describe el endpoint como stateless y señala que las conversaciones no se almacenan como estado reutilizable por el servidor. Esto no debe interpretarse automáticamente como una promesa de registro cero o ausencia de cualquier procesamiento operativo, de seguridad o legal.
La política general afirma que los datos personales recopilados para sus servicios se procesan y almacenan en la República Popular China. Si desarrollas una aplicación para terceros, las condiciones de la plataforma abierta también te hacen responsable de informar a tus usuarios y establecer una base legal para el tratamiento de sus datos.
No envíes claves API, contraseñas, datos de clientes, información médica, datos financieros sensibles, código confidencial o documentos que no tienes derecho a compartir. Elimina identificadores y aplica las políticas de tu organización antes de usar el chat o la API.
Preguntas frecuentes
¿Cuál es la versión más reciente de DeepSeek V4.1 Flash?
La versión actual verificada es DeepSeek-V4.1-Flash-1017, publicada el 17 de octubre de 2026. DeepSeek confirmó que también actualizó a esta versión los modelos de la web y la aplicación.
¿Qué identificador debo usar en la API?
Utiliza deepseek-flash. No envíes el nombre completo del checkpoint como identificador de la API oficial.
¿DeepSeek V4.1 Flash es gratis?
La API es un servicio por consumo y descuenta el costo de los tokens del saldo de la cuenta. El acceso y los límites del sitio web o la aplicación pueden tener condiciones diferentes y no deben confundirse con la facturación de la API.
¿Puede generar imágenes?
No. La modalidad documentada acepta texto e imágenes como entrada y genera texto. Puede analizar una imagen, pero no produce una imagen nueva como salida.
¿V4 Pro fue retirado?
No según la documentación actual. Aunque DeepSeek anunció inicialmente una retirada progresiva, después confirmó que mantendría V4 Pro por demanda de los usuarios. Su identificador continúa apareciendo en la tabla oficial de modelos y precios.
¿Puede ejecutarse en una computadora normal?
No debe asumirse. Los pesos están disponibles, pero el checkpoint es muy grande y el requisito depende de la precisión, la cuantización, el runtime y el contexto. DeepSeek no publica un mínimo universal para una computadora personal en la ficha actual.
¿Funciona bien en español?
Puede recibir y generar texto en español, pero la documentación principal no publica una métrica específica para español latinoamericano. Evalúalo con tus propios ejemplos antes de utilizarlo en soporte, redacción o automatizaciones dirigidas a usuarios hispanohablantes.
¿Es mejor que DeepSeek V4 Pro?
No existe una respuesta universal. Flash ofrece visión, una concurrencia mayor y precios inferiores en la API actual. V4 Pro continúa disponible, por lo que la elección debe basarse en pruebas comparables con tus tareas, no solo en el nombre del modelo.
¿Para quién tiene sentido DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash es una opción relevante para desarrolladores que necesitan combinar contexto largo, imágenes, razonamiento y herramientas con un costo de API bajo. La actualización 1017 refuerza especialmente los flujos de programación y agentes, según los resultados publicados por DeepSeek.
La decisión final debe basarse en una evaluación propia. Prueba tareas reales, registra tokens y costos, valida las herramientas, revisa la calidad en español y confirma que las condiciones de privacidad cumplen los requisitos de tu proyecto.
Fuentes consultadas
- Anuncio oficial de DeepSeek V4.1 Flash.
- Anuncio de DeepSeek-V4.1-Flash-1017.
- Registro de cambios de DeepSeek API.
- Modelos y precios de DeepSeek API.
- Metadatos oficiales de los modelos disponibles.
- Documentación de Thinking Mode.
- Documentación oficial de Vision.
- Documentación de FIM Completion.
- Repositorio oficial de DeepSeek-V4.1-Flash-1017.
- Política de privacidad de DeepSeek.
- Condiciones de la plataforma abierta de DeepSeek.