
DeepSeek API Thinking Mode permite generar razonamiento antes de la respuesta final. En Chat Completions, puedes activarlo con thinking.type y elegir el esfuerzo con reasoning_effort. El razonamiento llega en reasoning_content; la respuesta para tu aplicación, en content.
La guía oficial de Thinking Mode indica que está activado de forma predeterminada con esfuerzo high. Para declararlo explícitamente, estos son los campos que debes agregar al cuerpo de una solicitud de Chat Completions:
{
  "thinking": {"type": "enabled"},
  "reasoning_effort": "high"
}
A continuación encontrarás una llamada completa, ejemplos en Python y las diferencias que importan al trabajar con streaming, conversaciones y herramientas. Los ejemplos se dirigen a la API oficial de DeepSeek, no a un proveedor intermediario.
Qué es Thinking Mode y cuándo conviene usarlo
Piensa en este modo como una configuración de generación, no como otro producto que debas contratar por separado. Su utilidad debe evaluarse en el resultado: una explicación extensa no demuestra por sí sola que una solución sea correcta.
Como criterio de implementación, compara el modo sin pensamiento con low para tareas sencillas, y reserva las pruebas con high o max para problemas con varias restricciones, depuración y agentes. El registro oficial de cambios también orienta la selección del esfuerzo según la complejidad de la tarea.
Por ejemplo, reformular una frase y planificar tareas con dependencias no necesitan necesariamente la misma configuración. Antes de añadir más razonamiento, define qué contará como acierto: respetar todas las condiciones, superar una prueba de código o producir datos válidos.
Thinking no equivale a búsqueda web. Una solicitud sin herramientas de búsqueda no obtiene información actual solo por aumentar el esfuerzo. DeepSeek documenta Search y Fetch por separado. Tampoco debes confundir los controles de la aplicación de chat con los parámetros de tu integración.
Qué modelos usar en la API oficial
La tabla oficial de modelos documenta estas opciones, ambas compatibles con los modos con y sin pensamiento:
| ID para la solicitud | Versión servida documentada | Thinking Mode |
|---|---|---|
deepseek-flash | DeepSeek-V4.1-Flash-1017 | Compatible. |
deepseek-v4-pro | DeepSeek-V4-Pro-0813 | Compatible. |
No necesitas cambiar de identificador cada vez que activas o desactivas el razonamiento. Tampoco conviene iniciar una integración con deepseek-reasoner: es un nombre histórico cuya retirada fue anunciada en el lanzamiento de V4.
Para comprobar capacidades sin depender de una tabla copiada, consulta GET /models. Su respuesta puede incluir effort.supported_levels, effort.default_level y límites de contexto y salida. Algunos metadatos pueden omitirse cuando no están disponibles.
Cómo activar y desactivar Thinking Mode
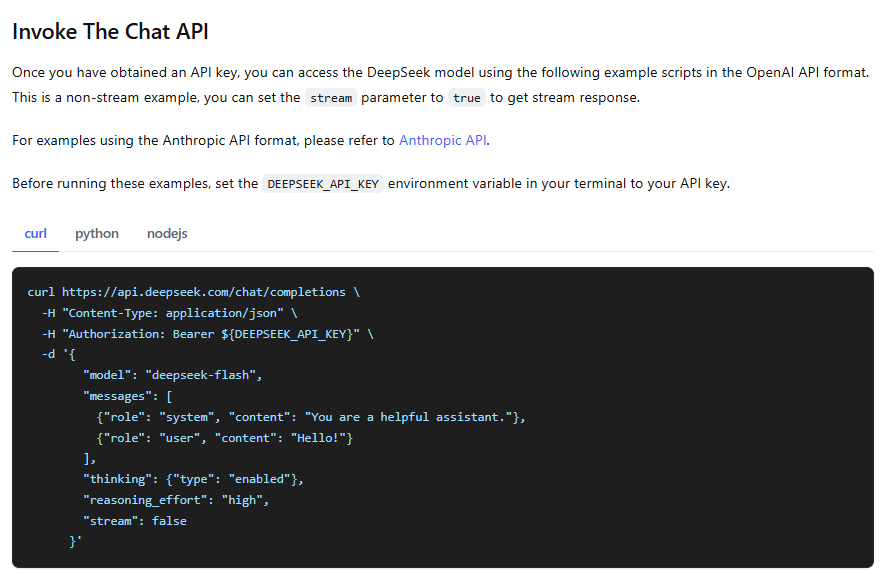
Primera llamada con cURL
Necesitas una API key de la plataforma de DeepSeek y saldo suficiente. La guía de inicio utiliza https://api.deepseek.com como URL base compatible con OpenAI. Usar esa compatibilidad no requiere una clave de OpenAI.
Este ejemplo es para Bash, en Linux, macOS o WSL. La lectura de la clave no la muestra en pantalla. Ejecuta las llamadas desde un entorno controlado y no publiques credenciales en el navegador, un repositorio o una captura.
read -r -s -p "API key de DeepSeek: " DEEPSEEK_API_KEY
printf '\n'
export DEEPSEEK_API_KEY

curl --silent --show-error \
  --connect-timeout 10 \
  --max-time 120 \
  https://api.deepseek.com/chat/completions \
  --header "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Distribuye tareas de 4, 7 y 3 minutos entre dos trabajadores. Cada trabajador hace una tarea a la vez y las tareas no se dividen. Minimiza la duración total y justifica la respuesta brevemente en español."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 4096,
    "stream": false
  }'
Los 120 segundos y los 4096 tokens son valores elegidos para el ejemplo, no recomendaciones universales. La solicitud puede consumir saldo. Para comprobar la solución del ejercicio, un trabajador puede realizar la tarea de 7 minutos y el otro las de 4 y 3: el total es 7 minutos. Esta comprobación es matemática, no una respuesta observada de la API.
Desactivar el razonamiento sin cambiar de modelo
En el mismo JSON, cambia thinking a {"type":"disabled"} y elimina reasoning_effort para no mantener controles contradictorios. En Python, el ajuste equivalente es:
extra_body={"thinking": {"type": "disabled"}}La referencia de Chat Completions también permite reasoning_effort="none" cuando no envías un thinking explícito. Si incluyes ambos, thinking.type tiene prioridad para seleccionar el modo. Si omites los dos, el pensamiento queda activado.
Ocultar el razonamiento no es desactivarlo. Mostrar únicamente content cambia tu interfaz, no la solicitud. Para comparar consumo entre modos, cambia el parámetro enviado al servidor y conserva el resto de las condiciones.
Cómo elegir reasoning_effort: low, high o max
Los niveles nativos son low, high y max. Esta es una propuesta de evaluación, no una garantía de calidad o velocidad:
| Configuración | Punto de partida para probar | Qué revisar |
|---|---|---|
| Sin pensamiento | Reformulación, formato y extracción sencilla. | Que la respuesta siga cumpliendo las reglas. |
low | Problemas acotados que necesitan algo de análisis. | Si aporta mejoras frente al modo desactivado. |
high | Programación, planificación y flujos con varios pasos. | Corrección y consumo en casos representativos. |
max | Casos difíciles en los que los niveles anteriores fallan. | Si la mejora justifica el tiempo y los tokens adicionales. |
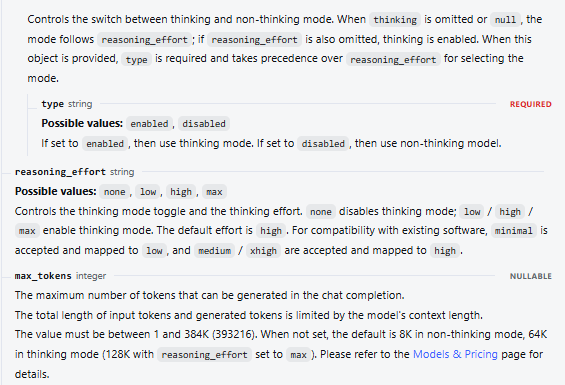
Consulta los niveles admitidos en el catálogo de modelos. Para una prueba útil, conserva el mismo modelo, prompt, herramientas y presupuesto de salida; cambia solamente el esfuerzo. Si modificas todo a la vez, no sabrás qué produjo la diferencia.
La documentación acepta algunas equivalencias de compatibilidad: minimal se convierte en low, mientras que medium y xhigh se convierten en high. xhigh no significa max. Para código nuevo, utiliza los valores nativos y evita depender de esos alias.
Ejemplo en Python: leer reasoning_content y content
Instala el SDK en el entorno de tu proyecto y conserva DEEPSEEK_API_KEY como variable de entorno:
python -m pip install --upgrade openaiEl SDK de Python permite enviar campos adicionales mediante extra_body. Esa opción pertenece a la biblioteca: en una solicitud HTTP directa, thinking va en el nivel superior del JSON, no dentro de una propiedad llamada extra_body.
Guarda el siguiente código como thinking_demo.py. Separa los dos campos y verifica que la respuesta de texto haya terminado antes de considerarla completa:
import os
import openai


def main() -> int:
    key = os.environ.get("DEEPSEEK_API_KEY", "").strip()
    if not key:
        print("Falta la variable DEEPSEEK_API_KEY.")
        return 1

    with openai.OpenAI(
        api_key=key,
        base_url="https://api.deepseek.com",
        timeout=120.0,
        max_retries=0,
    ) as client:
        try:
            response = client.chat.completions.create(
                model="deepseek-flash",
                messages=[{
                    "role": "user",
                    "content": (
                        "Distribuye tareas de 4, 7 y 3 minutos entre dos "
                        "trabajadores. No se pueden dividir las tareas. "
                        "Minimiza el tiempo total y responde en español."
                    ),
                }],
                reasoning_effort="high",
                max_tokens=4096,
                extra_body={"thinking": {"type": "enabled"}},
            )
        except openai.APIError as error:
            print(f"Error: {type(error).__name__}")
            print(f"HTTP: {getattr(error, 'status_code', 'no disponible')}")
            return 1

    if not response.choices:
        print("La respuesta no contiene choices.")
        return 1

    choice = response.choices[0]
    reasoning = getattr(choice.message, "reasoning_content", "") or ""
    answer = choice.message.content or ""

    # Solo para esta demostración; no registres datos privados en producción.
    print("Razonamiento devuelto:", reasoning)
    print("Respuesta final:", answer)
    print("finish_reason:", choice.finish_reason)
    if response.usage:
        print("Uso:", response.usage.model_dump_json())

    if choice.finish_reason != "stop" or not answer.strip():
        print("Revisa la salida: no hay una respuesta de texto completa.")
        return 1
    return 0


if __name__ == "__main__":
    raise SystemExit(main())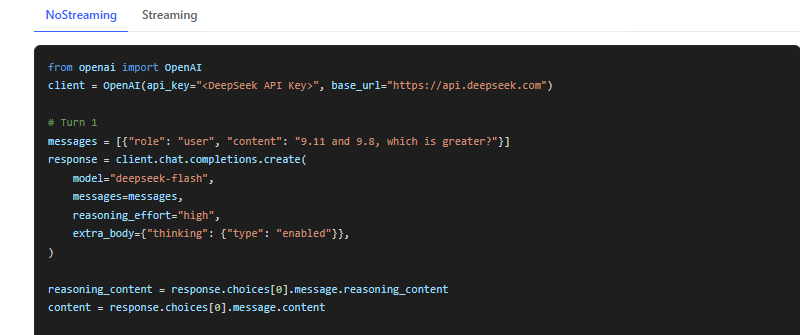
Ejecuta python thinking_demo.py. La validación está pensada para este ejemplo sin herramientas; tool_calls puede ser una terminación normal en un agente. Además, max_retries=0 evita reintentos automáticos durante la prueba. Define una política propia antes de llevarlo a producción.
Streaming: recibir el razonamiento y la respuesta por separado
Con streaming, reasoning_content y content llegan como fragmentos dentro de delta. La guía de Thinking Mode muestra este patrón. No busques etiquetas <think> dentro de la respuesta cuando estás consumiendo esos campos de Chat Completions.
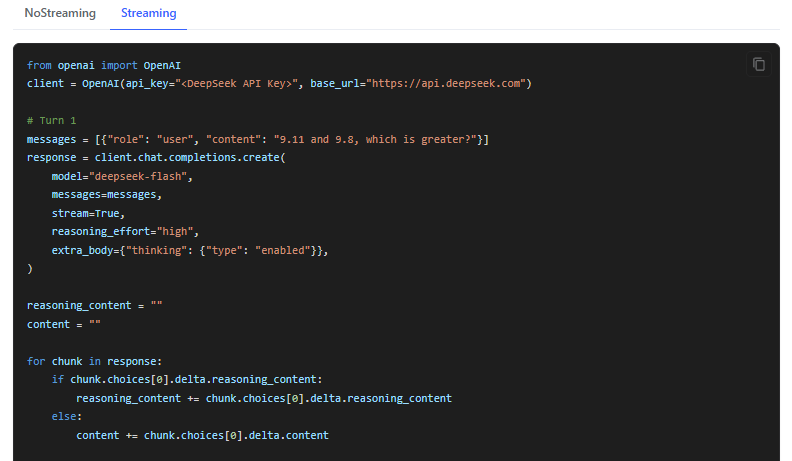
Este segundo ejemplo es independiente: guárdalo como thinking_stream.py y ejecútalo con la misma variable de entorno. Conserva los fragmentos por separado y comprueba el final del flujo. No utiliza herramientas:
import os
import openai


def stream_text(
    client: openai.OpenAI, messages: list[dict[str, str]]
) -> dict:
    reasoning_parts: list[str] = []
    answer_parts: list[str] = []
    finish_reason = None
    usage = None

    with client.chat.completions.create(
        model="deepseek-flash",
        messages=messages,
        reasoning_effort="high",
        max_tokens=4096,
        stream=True,
        stream_options={"include_usage": True},
        extra_body={"thinking": {"type": "enabled"}},
    ) as stream:
        for chunk in stream:
            if getattr(chunk, "usage", None) is not None:
                usage = chunk.usage.model_dump()
            if not chunk.choices:
                continue
            choice = chunk.choices[0]
            reasoning = getattr(choice.delta, "reasoning_content", None)
            text = choice.delta.content
            if reasoning:
                reasoning_parts.append(reasoning)
            if text:
                answer_parts.append(text)
                print(text, end="", flush=True)
            if choice.finish_reason is not None:
                finish_reason = choice.finish_reason

    answer = "".join(answer_parts)
    if finish_reason != "stop" or not answer.strip():
        raise RuntimeError("El stream no terminó con texto completo.")
    return {
        "reasoning_content": "".join(reasoning_parts),
        "content": answer,
        "usage": usage,
    }


if __name__ == "__main__":
    key = os.environ.get("DEEPSEEK_API_KEY", "").strip()
    if not key:
        raise SystemExit("Falta la variable DEEPSEEK_API_KEY.")
    try:
        with openai.OpenAI(
            api_key=key,
            base_url="https://api.deepseek.com",
            timeout=120.0,
            max_retries=0,
        ) as client:
            result = stream_text(client, [{
                "role": "user",
                "content": "Explica en español por qué 0.8 es mayor que 0.75.",
            }])
        print("\nUso:", result["usage"])
    except (openai.APIError, RuntimeError) as error:
        raise SystemExit(f"Error: {type(error).__name__}") from None
El código guarda el razonamiento, pero muestra solo la respuesta. Puede transcurrir un tiempo antes de imprimir texto; no es suficiente para diagnosticar un bloqueo. En una interfaz, muestra un indicador de actividad en lugar de fingir que ya llegó una respuesta final.
Para tus mediciones, distingue el primer fragmento recibido, el primer texto de respuesta y el tiempo total. Así no confundirás una llegada temprana de razonamiento con una respuesta útil más rápida. Si ocurre una excepción después de mostrar contenido, trata lo mostrado como parcial y evita duplicarlo con un reintento automático.
Conversaciones y herramientas: cuándo reenviar reasoning_content
Chat Completions es una API sin estado conversacional: tu aplicación debe enviar el historial necesario en cada llamada, según la guía de conversaciones de varias rondas. La regla específica del razonamiento depende de si la solicitud incluye tools.
Sin tools: conserva la conversación, no necesitas reenviar el razonamiento
Si la solicitud no incluye tools, el razonamiento anterior no se incorpora al contexto; si lo envías, se ignora. Conserva los mensajes de usuario y las respuestas finales que necesites para continuar la conversación.
Por ejemplo, después de una respuesta de texto completa, puedes añadir un mensaje del asistente con su content y luego la nueva pregunta. Evita mezclar conversaciones de usuarios diferentes en la misma lista.
Con tools: conserva el razonamiento de todos los turnos anteriores
Con tools, la regla oficial exige reenviar íntegro el reasoning_content de los turnos anteriores, incluso cuando un turno no llamó a ninguna herramienta. Omitirlo puede causar un 400.
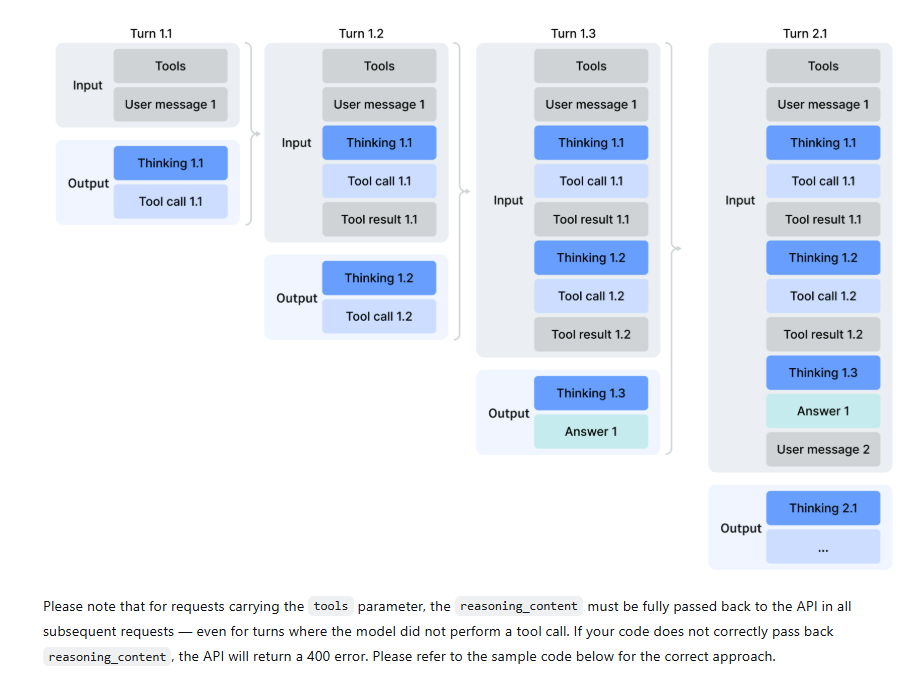
En tu bucle de herramientas, este fragmento conserva el mensaje completo recibido en una llamada sin streaming, antes de añadir los resultados de las funciones:
message = response.choices[0].message
messages.append(message.model_dump(exclude_none=True))
Después, añade un mensaje de rol tool por cada llamada ejecutada, con el tool_call_id correspondiente, y vuelve a enviar el historial. La guía de Tool Calls explica el intercambio: la función la ejecuta tu aplicación, no el modelo por sí solo.
Como protección de tu implementación, valida los argumentos antes de ejecutar funciones, limita las iteraciones del agente y no autorices operaciones sensibles únicamente porque aparezcan sugeridas en el razonamiento. Si usas streaming con herramientas, también necesitas reconstruir sus fragmentos; la función de texto anterior no implementa ese flujo.
Parámetros que no funcionan igual en Thinking Mode
La documentación del modo y la referencia del endpoint distinguen entre parámetros ignorados y ajustes que dependen del modelo:
| Parámetro | Con Thinking Mode activado |
|---|---|
temperature | No tiene efecto. No lo uses para controlar la profundidad del razonamiento. |
presence_penalty y frequency_penalty | No tienen efecto. |
top_p en Flash | Sí tiene efecto entre 0.95 y 1.0; un valor inferior se trata como 0.95. |
top_p en Pro | Tu valor se ignora: queda en 0.95 con llamadas a herramientas habilitadas y en 1.0 en caso contrario. |
En Pro, tool_choice="none" deshabilita las llamadas a herramientas aunque hayas enviado tools. Los parámetros indicados como ignorados no producen un error solo por estar presentes. Para diagnosticar, empieza con una solicitud pequeña y añade únicamente opciones que cumplan una función comprobable.
Tokens, costo y presupuesto de salida
La facturación oficial se basa en tokens de entrada y salida, con tarifas diferenciadas según el modelo y las condiciones publicadas. No estimes el costo contando únicamente las palabras de content: el razonamiento también forma parte de la generación.
Revisa usage.completion_tokens y, cuando esté presente, usage.completion_tokens_details.reasoning_tokens. Este último es un desglose, no una cantidad que debas sumar otra vez al total de salida. La guía de tokens recomienda tomar el uso devuelto por la API como referencia, en lugar de convertir palabras a tokens con una proporción fija.
Para estimar solo el componente de generación, utiliza tokens de salida ÷ 1,000,000 × tarifa de salida aplicable. Añade por separado la entrada, diferenciando caché cuando corresponda, y cualquier servicio adicional. No conviertas una tarifa antigua en una estimación actual sin revisar la tabla oficial.
En Chat Completions, la referencia fija valores predeterminados de max_tokens de 8K sin pensamiento, 64K con pensamiento y 128K con esfuerzo max. Ese parámetro limita la generación; no reserva toda esa cantidad exclusivamente para la respuesta final. El presupuesto permitido también depende del espacio de contexto disponible.
Para producción, mide calidad, consumo y tiempo sobre un conjunto representativo de tareas. Aumenta el esfuerzo o el presupuesto cuando una prueba lo justifique, no para compensar un prompt ambiguo. Un límite configurado es un techo, no una promesa de que la solicitud consumirá exactamente esa cantidad.
Usar Thinking Mode con JSON Output
Los modelos actuales permiten combinar razonamiento y JSON Output. Para solicitar JSON, agrega response_format={"type":"json_object"}, pide explícitamente JSON en el mensaje y muestra un ejemplo de la estructura esperada, como indica la guía oficial.
Analiza el campo content, no la concatenación de razonamiento y respuesta. Comprueba primero que no esté vacío después de aplicar strip(), luego analiza el JSON y valida sus campos. Un JSON válido no demuestra que sus datos sean correctos ni que cumpla tu esquema.
Hay una particularidad importante: si la salida no se reconoce como JSON, la API puede sustituirla por espacios, incluso con finish_reason="stop". Además, una salida truncada necesita un tratamiento diferente. No guardes cualquiera de esos resultados como una operación exitosa.
Chat Completions, Responses y Anthropic: no mezcles formatos
El mismo objetivo se expresa con campos distintos. La referencia de Responses y la compatibilidad con Anthropic documentan estas configuraciones:
| Formato | Activar y elegir esfuerzo | Desactivar |
|---|---|---|
| Chat Completions | thinking: {"type":"enabled"} y reasoning_effort: "high". | thinking: {"type":"disabled"}. |
| Responses API | reasoning: {"effort":"high"}. | reasoning: {"effort":"none"}. |
| Anthropic Messages | thinking: {"type":"enabled"} y output_config: {"effort":"high"}. | thinking: {"type":"disabled"}. |
En Responses, el razonamiento aparece como un elemento de tipo reasoning, no como choices[0].message.reasoning_content. Su streaming utiliza eventos semánticos y finaliza con un evento de respuesta completada, incompleta o fallida, según la guía correspondiente. No reutilices sin cambios el lector de Chat Completions.
En la compatibilidad Anthropic de DeepSeek, thinking.budget_tokens se ignora; no equivale a fijar el esfuerzo. Para ciertos agentes existen además excepciones de compatibilidad que pueden elevar el max_tokens efectivo. Revisa ese comportamiento antes de tratarlo como un techo estricto en todos los clientes.
Errores frecuentes al integrar el modo de pensamiento
Antes de reintentar, distingue un problema de parámetros, uno de historial y uno de cuenta. Esta tabla combina las reglas anteriores con la referencia oficial de errores:
| Síntoma | Qué comprobar |
|---|---|
El SDK rechaza thinking como argumento. | En el SDK de Python, envíalo dentro de extra_body. |
No aparece reasoning_content. | Comprueba el modo, el formato de API y si un intermediario elimina el campo. |
Un agente devuelve 400 al continuar. | Inspecciona el mensaje de error y comprueba que conservas el razonamiento con tools. |
La generación termina con length. | Revisa el presupuesto de generación y la longitud del contexto antes de guardar la salida. |
La solicitud devuelve 401 o 402. | Revisa la clave o el saldo, respectivamente; aumentar el esfuerzo no lo resolverá. |
Aparece 429. | Reduce la carga y revisa los límites; evita reintentos sin control. |
Ante un timeout, no supongas que el modo está desactivado ni que el servidor no procesó la llamada. Revisa los plazos del cliente y de los componentes intermedios. Guarda el estado de la operación y evita duplicar acciones si tu agente utiliza herramientas.
Preguntas frecuentes
¿Escribir “piensa paso a paso” activa Thinking Mode?
No sustituye configurar la solicitud. Para saber qué modo usas, inspecciona los parámetros que salen de tu aplicación. Un prompt puede pedir una explicación, pero eso es distinto de seleccionar el modo de la API.
¿Puedo mostrar solo la respuesta final?
Sí. Tu interfaz puede mostrar solo content. Mantén separado el historial que necesita tu aplicación: ocultar información en pantalla no debe borrar campos necesarios para continuar un flujo con herramientas.
¿El esfuerzo max siempre da mejores respuestas?
No lo trates como una garantía. Compara resultados con pruebas verificables y considera el tiempo y el costo. Para una tarea concreta, la mejor configuración es la que cumple sus requisitos con un consumo aceptable.
¿Puedo obtener la respuesta en español?
Solicita español latinoamericano neutro en las instrucciones y evalúa la respuesta final. No diseñes tu aplicación suponiendo que el idioma o la redacción del razonamiento coincidirán siempre con el texto que mostrarás al usuario.
Para empezar: declara el modo explícitamente, usa un presupuesto acotado y verifica una solicitud sencilla. Después incorpora streaming e historial. La diferencia decisiva en un agente no es solo cuánto piensa el modelo, sino si tu aplicación conserva correctamente los mensajes y valida las acciones.
Última verificación documental: 10 de noviembre de 2026. Los ejemplos se basan en las fuentes oficiales enlazadas; no se realizaron llamadas autenticadas a DeepSeek para este artículo.