
DeepSeek V4 Pro es un modelo de texto orientado a razonamiento complejo, programación y flujos de agentes. La versión que continúa activa en la API oficial es DeepSeek-V4-Pro-0813, accesible mediante el identificador deepseek-v4-pro.
Aunque DeepSeek anunció en septiembre de 2026 que planeaba sustituirlo por V4.1 Flash, después decidió mantener el servicio debido a la demanda de los usuarios. En esta guía encontrarás su estado actual, especificaciones, precio, diferencias frente a Flash, funciones de búsqueda web, ejemplo de API, benchmarks, opciones de descarga y límites importantes.
Información verificada el 10 de noviembre de 2026.
¿DeepSeek V4 Pro sigue disponible?
Sí. La documentación oficial continúa mostrando deepseek-v4-pro como uno de los modelos disponibles en la API. El endpoint de modelos identifica su versión como DeepSeek-V4-Pro-0813, con entrada y salida de texto.
La confusión se debe a una secuencia de anuncios diferentes:
| Fecha | Cambio | Qué significa ahora |
|---|---|---|
| 24 de abril de 2026 | DeepSeek presentó V4 Pro Preview junto con V4 Flash | Fue la primera versión pública de la familia |
| 13 de agosto de 2026 | Se lanzó DeepSeek-V4-Pro-0813 como versión GA | Sustituyó a Preview y mantuvo el ID deepseek-v4-pro |
| 10 de septiembre de 2026 | El anuncio de V4.1 Flash comunicó una retirada progresiva de V4 Pro | El plan inicial era redirigir las solicitudes a Flash |
| Actualización posterior | DeepSeek decidió continuar ofreciendo V4 Pro por la demanda de los usuarios | El modelo permanece disponible con su precio y facturación propios |
| 10 de noviembre de 2026 | Models & Pricing y List Models todavía muestran V4 Pro | No existe un aviso oficial vigente de retirada definitiva |
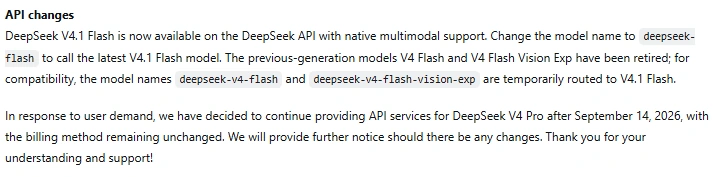
Por tanto, una página que afirme que V4 Pro fue eliminado el 14 de septiembre está usando el anuncio inicial sin incorporar la decisión posterior. La fuente que debe prevalecer es la documentación operativa actual.
Especificaciones actuales de DeepSeek V4 Pro
| Característica | Dato actual |
|---|---|
| Versión alojada | DeepSeek-V4-Pro-0813 |
| ID de la API | deepseek-v4-pro |
| Entrada | Texto |
| Salida | Texto |
| Visión e imágenes | No compatible en la versión actual |
| Ventana de contexto | 1,048,576 tokens |
| Salida máxima | 393,216 tokens, equivalentes a 384K |
| Thinking Mode | Compatible y activado de forma predeterminada |
| Esfuerzo de razonamiento | low, high y max; none desactiva el razonamiento |
| Tool Calls | Sí |
| JSON Output | Sí |
| Responses API | Sí |
| Anthropic API | Sí |
| Chat Prefix Completion | Beta |
| FIM Completion | Beta, solo en modo sin razonamiento |
| Web search integrada | Sí, mediante Responses API |
| Concurrencia | 500 solicitudes simultáneas por cuenta |
| Pesos publicados | Sí, bajo licencia MIT |
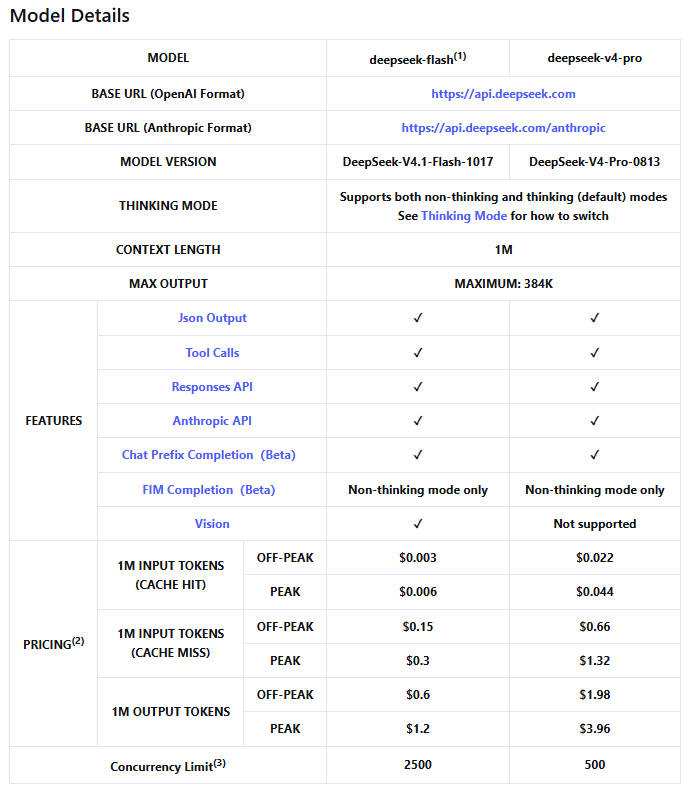
La concurrencia se calcula a nivel de cuenta, no por clave. Si varias aplicaciones utilizan claves distintas de una misma cuenta, comparten el límite de 500 solicitudes simultáneas.
DeepSeek V4 Pro Preview frente a la versión 0813
DeepSeek-V4-Pro-0813 es la versión de disponibilidad general, también denominada GA. Sustituye oficialmente a DeepSeek V4 Pro Preview, pero conserva su estructura principal.
Los cambios más relevantes de la versión GA son:
- Mejoras publicadas en programación, razonamiento y tareas con agentes.
- Compatibilidad nativa con el formato Responses API.
- Integración adaptada a Codex.
- Control de razonamiento mediante los niveles
low,highymax. - Incorporación de DSpark para speculative decoding.
- Recetas oficiales actualizadas para vLLM y SGLang.
El sufijo 0813 identifica la versión GA publicada el 13 de agosto de 2026. Para utilizarla mediante la API de DeepSeek no debes escribir el nombre completo del checkpoint; el campo model sigue siendo deepseek-v4-pro.
Qué significan 1.6T, 1.7T y 49B activos
DeepSeek V4 Pro utiliza una arquitectura Mixture of Experts, o MoE. Esto significa que contiene numerosos bloques especializados, pero solo activa una parte de ellos para procesar cada token.
| Cifra | Qué representa |
|---|---|
| 1.6T | Total de parámetros publicado para la arquitectura de V4 Pro Preview |
| 49B | Parámetros activados por token en la arquitectura publicada |
| 1.7T | Tamaño de modelo que muestra actualmente la interfaz de Hugging Face para el checkpoint 0813 |
No es correcto describir DeepSeek V4 Pro como un modelo de 49B. Esa cifra corresponde a los parámetros activos por token, no al total de parámetros que contiene el modelo.
Tampoco conviene tratar 1.6T y 1.7T como si fueran mediciones idénticas. La documentación original utiliza 1.6T para la arquitectura de Preview, mientras que Hugging Face etiqueta el checkpoint 0813 como un modelo de 1.7T. Las fuentes consultadas no publican una reconciliación detallada entre ambos campos, por lo que no debe inventarse una explicación.
DeepSeek Sparse Attention
La familia V4 introdujo DeepSeek Sparse Attention, una técnica diseñada para reducir el trabajo necesario al procesar contextos extensos. En lugar de aplicar la misma atención completa a todas las posiciones, intenta concentrar el cálculo en las relaciones más relevantes.
Esta arquitectura ayuda a hacer viable una ventana de un millón de tokens, pero no garantiza una recuperación perfecta de todos los detalles. Una aplicación debe evaluar si el modelo encuentra información colocada al inicio, en el centro y al final de entradas largas.
Qué aporta DSpark
DeepSeek-V4-Pro-0813 incorpora DSpark, un módulo de speculative decoding. Esta técnica intenta acelerar la generación utilizando predicciones preliminares que después valida el modelo principal.
DSpark no es un modelo diferente. La ficha oficial lo describe como el mismo checkpoint de V4 Pro con un módulo adicional de decodificación especulativa.
Su presencia tampoco garantiza una latencia específica. La velocidad final depende del hardware, el runtime, el nivel de paralelismo, el tamaño del lote, la longitud del contexto y la configuración utilizada.
Contexto de un millón de tokens y salida de 384K
DeepSeek V4 Pro admite una ventana de contexto de 1,048,576 tokens. Este límite incluye la suma de los mensajes, las instrucciones, los resultados de herramientas, el razonamiento y la respuesta generada.
La salida máxima es de 393,216 tokens, o 384K. Sin embargo, los valores predeterminados son más bajos:
- 8K tokens en modo sin razonamiento.
- 64K tokens en Thinking Mode con el esfuerzo predeterminado.
- 128K tokens cuando se utiliza
reasoning_effort="max". - Hasta 384K cuando el desarrollador configura expresamente un límite superior permitido.
La ventana de contexto no equivale al tamaño de la respuesta. Tampoco significa que el modelo pueda procesar un millón de tokens y recuperar cada dato con la misma fiabilidad.
Para documentos o repositorios extensos, prueba la recuperación en diferentes posiciones, solicita referencias a secciones concretas y comprueba manualmente los datos importantes.
Thinking Mode y niveles de razonamiento
Thinking Mode está activado de forma predeterminada con el nivel high. La API permite elegir entre:
| Valor | Comportamiento | Uso orientativo |
|---|---|---|
none | Desactiva Thinking Mode | Respuestas breves, clasificación o transformación simple |
low | Reduce el esfuerzo de razonamiento | Tareas sencillas o sensibles a latencia |
high | Nivel predeterminado | Trabajo cotidiano con código, análisis y agentes |
max | Mayor esfuerzo disponible | Problemas complejos que justifican más consumo y tiempo |
Un nivel más alto no garantiza una respuesta mejor. Debes medir calidad, duración, razonamiento consumido y costo con las tareas reales de tu proyecto.
En Thinking Mode, temperature, presence_penalty y frequency_penalty no tienen efecto. Para V4 Pro, el valor de top_p también se ignora durante el razonamiento: se fija en 0.95 cuando hay Tool Calls y en 1.0 cuando no las hay.
Cuando utilizas herramientas con Chat Completions, debes conservar y reenviar correctamente reasoning_content en las rondas posteriores. Si se omite en una conversación con herramientas, la API puede responder con un error 400.
Tool Calls, Responses API y búsqueda web
DeepSeek V4 Pro puede decidir cuándo llamar una herramienta y generar sus argumentos. Esto no significa que el modelo ejecute directamente una consulta, modifique archivos o acceda a una terminal.
Tu aplicación o el agente debe validar los argumentos, ejecutar la acción y devolver el resultado al modelo. Las operaciones sensibles necesitan límites, aprobación y registros.
Web search integrada en Responses API
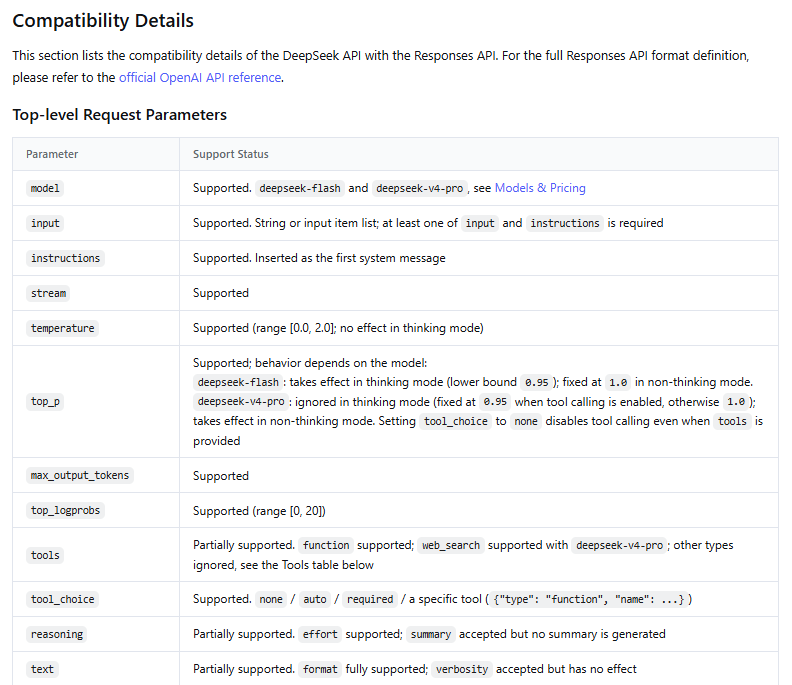
Una diferencia práctica de V4 Pro es que Responses API admite la herramienta integrada web_search. DeepSeek ejecuta la búsqueda en el servidor, incorpora los resultados al contexto y continúa generando la respuesta.
Esta herramienta integrada está documentada para deepseek-v4-pro. Si se envía con deepseek-flash, se ignora.
Diferencia entre web_search, Search API y Fetch API
| Opción | Cómo funciona | Cuándo utilizarla |
|---|---|---|
web_search | Herramienta gestionada por DeepSeek dentro de Responses API | Cuando quieres que V4 Pro decida buscar y use los resultados en una misma respuesta |
| Search API | Endpoint independiente que devuelve resultados estructurados | Cuando tu aplicación necesita controlar consultas, cantidad de resultados y contenido |
| Fetch API | Recupera una página y devuelve su contenido como Markdown | Cuando ya tienes una URL y necesitas leerla para RAG o un agente |
Search y Fetch son interfaces JSON independientes. Sus endpoints actuales son:
POST https://api.deepseek.com/v1/tools/search
POST https://api.deepseek.com/v1/tools/fetch
Estas herramientas son de solo lectura. No publican contenido ni interactúan con formularios en nombre del usuario.
Límites de Responses API
La compatibilidad con el formato Responses de OpenAI no es completa. Entre las diferencias actuales:
- La API es stateless.
previous_response_idno está soportado.conversationno está soportado.storeno está soportado y siempre se devuelve comofalse.backgroundno está soportado.file_search,code_interpreter,computer_useymcpse ignoran.- La herramienta personalizada admitida es
apply_patch, principalmente por compatibilidad con Codex. - Los parámetros no compatibles pueden ignorarse silenciosamente en vez de producir un error.
Por esta razón, una aplicación no debe asumir compatibilidad total solo porque utiliza el mismo SDK o una estructura de solicitud similar.
¿DeepSeek V4 Pro admite imágenes?
No. La ficha actual de la API define entradas y salidas de texto para deepseek-v4-pro. La tabla oficial de modelos indica expresamente que Vision no está soportada.
No debes enviar una captura, fotografía o PDF visual esperando que V4 Pro lo interprete directamente. Para analizar imágenes dentro de la API oficial, la alternativa actual de la misma familia es deepseek-flash, que sirve DeepSeek-V4.1-Flash-1017.
V4 Pro sí puede trabajar con texto extraído previamente mediante OCR, con contenido devuelto por Fetch API o con datos que otra herramienta haya convertido a texto. En ese caso, el análisis se realiza sobre el texto proporcionado, no sobre la imagen original.
Benchmarks publicados para V4 Pro 0813
La ficha oficial publica mejoras importantes de la versión 0813 frente a Preview. Los siguientes resultados proceden de DeepSeek y no constituyen una prueba independiente realizada para este artículo.
| Benchmark | V4 Pro Preview | V4 Pro 0813 |
|---|---|---|
| HLE sin herramientas | 37.7 | 42.7 |
| HLE con herramientas | 48.2 | 60.0 |
| Terminal-Bench 2.1 | 72.1 | 87.9 |
| NL2Repo | 38.5 | 61.5 |
| CyberGym | 52.7 | 83.3 |
| DeepSWE | 12.8 | 62.7 |
| Toolathlon-Verified | 55.9 | 74.1 |
| Agents’ Last Exam | 16.5 | 25.7 |
| AutomationBench público | 12.8 | 31.8 |
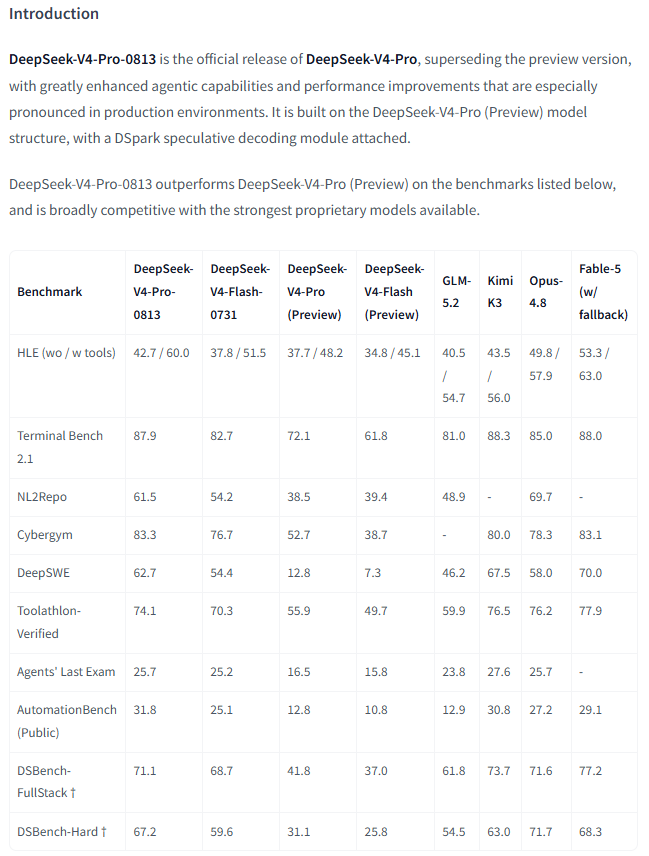
Para las tareas públicas de agentes de código, DeepSeek evaluó V4 Pro 0813 mediante el modo minimal de DeepSeek Harness, con reasoning_effort="max", temperature=1.0 y top_p=0.95.
La ficha también incluye DSBench-FullStack y DSBench-Hard, pero DeepSeek los identifica como conjuntos de prueba internos. No deben presentarse como validación independiente.
Un benchmark no predice por sí solo el resultado en tu repositorio. Evalúa el modelo con errores reales, pull requests, pruebas, herramientas y criterios de seguridad propios.
Precio de DeepSeek V4 Pro
La API se factura por cada millón de tokens. La entrada tiene dos tarifas: cache hit cuando el prefijo reutilizado se encuentra en la caché automática, y cache miss cuando debe procesarse como entrada nueva.
| Concepto por 1M de tokens | Hora valle | Hora punta |
|---|---|---|
| Entrada con cache hit | US$0.022 | US$0.044 |
| Entrada con cache miss | US$0.66 | US$1.32 |
| Salida | US$1.98 | US$3.96 |
Las horas punta son de 01:00 a 04:00 UTC y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los días festivos oficiales de China. Los fines de semana, los festivos chinos completos y las demás horas utilizan la tarifa valle.
Ejemplo de costo
Supón una solicitud con 800,000 tokens de entrada y 100,000 tokens de salida en total: 900,000 tokens, dentro de la ventana de 1,048,576. Para el cálculo, la entrada equivale a 0.8 millones de tokens y la salida a 0.1 millones:
- Cache miss en hora valle: (0.8 × US$0.66) + (0.1 × US$1.98) = US$0.726.
- Cache miss en hora punta: (0.8 × US$1.32) + (0.1 × US$3.96) = US$1.452.
- Cache hit en hora valle: (0.8 × US$0.022) + (0.1 × US$1.98) = US$0.2156.
- Cache hit en hora punta: (0.8 × US$0.044) + (0.1 × US$3.96) = US$0.4312.
Estos cálculos son ilustrativos. La factura real depende de los tokens contabilizados, el porcentaje de entrada en caché, el razonamiento, la hora de la solicitud y las herramientas utilizadas.
Precio de Search y Fetch
| API | Unidad | Precio |
|---|---|---|
| Search | 1,000 solicitudes exitosas | US$0.75 |
| Fetch | 1,000 solicitudes exitosas | US$0.75 |
Solo se factura una solicitud que devuelve HTTP 200 y produce un resultado válido. Los errores, tiempos de espera y búsquedas vacías no se cobran.
DeepSeek V4 Pro vs V4.1 Flash
| Característica | DeepSeek V4 Pro | DeepSeek V4.1 Flash |
|---|---|---|
| Versión actual | DeepSeek-V4-Pro-0813 | DeepSeek-V4.1-Flash-1017 |
| ID de API | deepseek-v4-pro | deepseek-flash |
| Entrada | Texto | Texto e imágenes |
| Salida | Texto | Texto |
| Contexto | 1M | 1M |
| Salida máxima | 384K | 384K |
| Thinking Mode | Sí | Sí |
| Tool Calls | Sí | Sí |
| Responses API | Sí | Sí |
| Web search integrada | Sí | Se ignora |
| FIM | Beta, sin razonamiento | Beta, sin razonamiento |
| Concurrencia por cuenta | 500 | 2,500 |
| Cache miss valle | US$0.66 por 1M | US$0.15 por 1M |
| Salida valle | US$1.98 por 1M | US$0.60 por 1M |
V4 Pro puede tener sentido cuando necesitas la herramienta web_search integrada en Responses API o cuando tus pruebas internas muestran una ventaja suficiente en razonamiento, código o agentes para justificar el precio y la menor concurrencia.
V4.1 Flash suele ser el punto de partida más práctico cuando necesitas imágenes, más concurrencia, menor costo o una implementación general de chat, programación y herramientas.
No elijas únicamente por la palabra “Pro” o porque Flash sea más reciente. Ejecuta el mismo conjunto de tareas con ambos modelos y compara calidad, llamadas correctas a herramientas, latencia, consumo y costo.
Cómo acceder a DeepSeek V4 Pro
Web y aplicación
El anuncio de disponibilidad general del 13 de agosto de 2026 habilitó V4 Pro en la web y la aplicación mediante Expert Mode. La etiqueta, posición del selector y límites de la interfaz pueden cambiar, por lo que debes revisar el modelo que muestra tu sesión actual.
La interfaz de chat y la API son servicios diferentes. Que el sitio permita usar un modo determinado no significa que ofrezca los mismos límites, controles o versión identificable que la API.
API oficial
La forma verificable de solicitar el modelo es utilizar:
model="deepseek-v4-pro"
base_url="https://api.deepseek.com"
No utilices DeepSeek-V4-Pro-0813 como ID de la API alojada. Ese es el nombre del checkpoint y de la versión, no el identificador aceptado por el servicio oficial.
Ejemplo de DeepSeek V4 Pro API con Python
Instala primero el SDK compatible:
pip install --upgrade openaiGuarda la clave en la variable de entorno DEEPSEEK_API_KEY y ejecuta:
import os
import sys

from openai import OpenAI


api_key = os.getenv("DEEPSEEK_API_KEY")

if not api_key:
    sys.exit(
        "Define la variable DEEPSEEK_API_KEY antes de ejecutar el script."
    )

client = OpenAI(
    api_key=api_key,
    base_url="https://api.deepseek.com",
)

try:
    response = client.chat.completions.create(
        model="deepseek-v4-pro",
        messages=[
            {
                "role": "system",
                "content": (
                    "Responde en español latinoamericano neutro. "
                    "Señala los supuestos que no puedas verificar."
                ),
            },
            {
                "role": "user",
                "content": (
                    "Diseña un plan de pruebas para una API que recibe "
                    "pagos y debe evitar solicitudes duplicadas."
                ),
            },
        ],
        reasoning_effort="high",
        extra_body={
            "thinking": {
                "type": "enabled"
            }
        },
        max_tokens=1200,
        stream=False,
    )

    print(response.choices[0].message.content)

except Exception as exc:
    print(f"Error al llamar a DeepSeek API: {exc}")
Este ejemplo se basa en la documentación oficial vigente, pero no se ejecutó con una clave real para este artículo. Debes probarlo en tu entorno y añadir tiempos de espera, reintentos, registros y controles de gasto antes de utilizarlo en producción.
Ejemplo con web_search en Responses API
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.responses.create(
    model="deepseek-v4-pro",
    reasoning={
        "effort": "none"
    },
    tools=[
        {
            "type": "web_search"
        }
    ],
    input=(
        "Busca la documentación oficial de Python y responde "
        "solo con la URL principal y el título de la página."
    ),
)

print(response.output_text)
La respuesta incluye contadores de uso de herramientas en usage.server_tool_use. Registra esos valores para controlar las búsquedas y lecturas facturables.
¿Se puede descargar y ejecutar localmente?
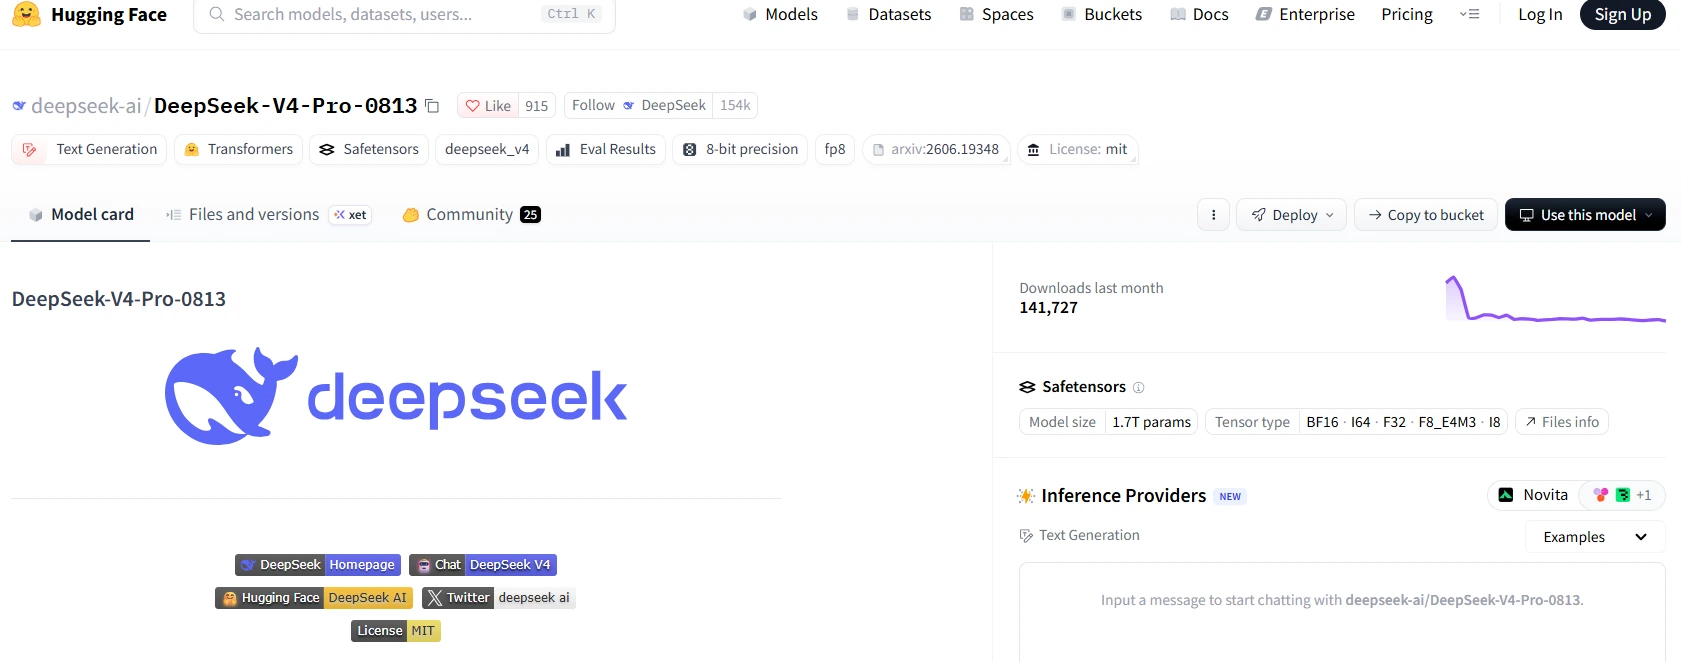
Sí. DeepSeek publicó el checkpoint DeepSeek-V4-Pro-0813 en su cuenta oficial de Hugging Face. El repositorio y los pesos están licenciados bajo MIT.
La disponibilidad de los pesos no significa que sea sencillo ejecutarlos en una computadora personal. Hugging Face muestra un tamaño de modelo de aproximadamente 1.7T parámetros, y la ficha oficial proporciona recetas para infraestructuras de vLLM y SGLang.
Una de las configuraciones de ejemplo utiliza un nodo con cuatro GPU GB300 y paralelismo de expertos. Es un ejemplo de despliegue, no un requisito mínimo universal.
Los recursos necesarios cambian según:
- La precisión de los pesos.
- La cuantización.
- El runtime.
- La longitud de contexto.
- El tamaño del lote.
- El paralelismo de datos, tensores y expertos.
- El tipo de KV cache.
- El uso de DSpark.
- El nivel de razonamiento.
- El nivel de offloading hacia CPU o almacenamiento.
No existe un requisito único de RAM o GPU que represente todas las configuraciones. Tampoco debes asumir que una cuantización creada por terceros conserva la misma calidad, velocidad, contexto o compatibilidad con herramientas.
La licencia MIT de los pesos no sustituye los términos de DeepSeek API, las políticas de privacidad, las licencias del runtime ni las obligaciones legales relacionadas con tus datos y aplicaciones.
¿Para qué casos puede servir V4 Pro?
| Caso | Por qué puede encajar | Qué debes verificar |
|---|---|---|
| Agentes con acceso web | Responses API admite web_search integrada | Calidad de fuentes, consultas ejecutadas, costo y citas |
| Programación compleja | La versión 0813 fue optimizada para agentes de código | Pruebas, regresiones, dependencias y seguridad |
| Repositorios extensos | Contexto de hasta 1M | Recuperación, archivos omitidos y costo de entrada |
| Automatización con herramientas | Thinking Mode y Tool Calls | Argumentos inválidos, permisos y acciones irreversibles |
| Investigación con contenido web | Búsqueda integrada, Search API y Fetch API | Actualidad, autoridad de las fuentes y contenido recuperado |
| Salida estructurada | JSON Output y esquemas mediante Responses API | Campos ausentes, JSON vacío, truncamiento y validación |
| Experimentación local | Pesos publicados bajo MIT | Infraestructura, runtime, cuantización y rendimiento real |
Para tareas con imágenes, alta concurrencia o presupuestos más ajustados, V4.1 Flash puede ser una alternativa más apropiada.
Checklist antes de utilizarlo en producción
- Confirma que
deepseek-v4-prosigue apareciendo en List Models. - Define una colección de tareas reales y criterios de aceptación.
- Compara
low,highymaxcon los mismos prompts. - Mide tokens de entrada, razonamiento y salida.
- Registra el porcentaje de cache hit.
- Evalúa la recuperación en diferentes zonas del contexto.
- Valida los argumentos de cada Tool Call antes de ejecutarla.
- Limita permisos, comandos, archivos y acciones irreversibles.
- Controla las búsquedas y lecturas web facturables.
- Comprueba errores 429 y diseña colas o reintentos.
- Repite las pruebas cuando cambie la versión alojada.
- Evalúa el español con datos de tu propio producto.
- Revisa privacidad, residencia de datos y obligaciones contractuales.
Privacidad y seguridad
La política de privacidad de DeepSeek indica que puede recopilar prompts, archivos, fotografías, historial del chat y otros contenidos proporcionados por el usuario. También contempla el uso de datos para operar, desarrollar y mejorar sus servicios y tecnologías.
La política ofrece la posibilidad de excluir el uso de datos personales para entrenar modelos u optimizar tecnologías mediante los controles disponibles. Esto no debe interpretarse como una garantía de almacenamiento cero o eliminación inmediata de todos los registros operativos.
DeepSeek declara que los datos personales recopilados para prestar sus servicios pueden procesarse y almacenarse en la República Popular China. Las empresas deben evaluar este punto junto con sus obligaciones legales, contractuales y de residencia de datos.
Si utilizas la API para crear una aplicación destinada a terceros, las condiciones de la plataforma te hacen responsable de informar a los usuarios sobre el tratamiento de sus datos, establecer una base legal y aplicar medidas de seguridad.
No envíes sin una necesidad justificada:
- Claves API, access tokens o contraseñas.
- Private keys o certificados.
- Archivos
.env. - Datos personales de clientes o empleados.
- Información médica o financiera sensible.
- Código propietario sin autorización.
- Contratos y documentos internos confidenciales.
- Logs que contengan credenciales o identificadores.
- Contenido que no tienes derecho a compartir.
Elimina secretos, utiliza datos ficticios cuando sea posible y comparte solo el contexto mínimo necesario. En agentes, revisa cada comando y cambio antes de permitir su ejecución.
Limitaciones de DeepSeek V4 Pro
- No admite imágenes en la versión actual de la API.
- Es más costoso y tiene menor concurrencia que V4.1 Flash.
- Puede inventar hechos, funciones, dependencias o referencias.
- Un contexto de 1M no garantiza recuperación perfecta.
- Thinking Mode puede aumentar tiempo y consumo sin mejorar todas las tareas.
- Tool Calls requieren validación y ejecución externa.
- Responses API no ofrece compatibilidad completa con todos los campos de OpenAI.
- Algunos parámetros no compatibles se ignoran silenciosamente.
- El despliegue local completo requiere infraestructura considerable.
- Los benchmarks oficiales no sustituyen una evaluación independiente.
- El nombre de API puede apuntar a una versión actualizada en el futuro.
Preguntas frecuentes sobre DeepSeek V4 Pro
¿Cuál es la versión actual de DeepSeek V4 Pro?
La versión alojada actualmente es DeepSeek-V4-Pro-0813. En la API debes utilizar el identificador deepseek-v4-pro.
¿DeepSeek V4 Pro fue eliminado?
No. DeepSeek anunció inicialmente una retirada progresiva, pero después decidió continuar ofreciendo el servicio por la demanda de los usuarios. El modelo sigue apareciendo en la documentación operativa actual.
¿Es gratis?
La API no es gratuita: se factura por tokens y por las herramientas web utilizadas. El acceso desde la web o la aplicación puede tener condiciones y límites diferentes, por lo que no debe confundirse con la facturación de API.
¿Puede analizar imágenes?
No mediante la versión actual de deepseek-v4-pro. Para entradas de imágenes, la opción oficial actual es deepseek-flash.
¿Puede buscar en Internet?
Sí, cuando se utiliza la herramienta web_search en Responses API. También puedes integrar Search API y Fetch API como servicios independientes.
¿Es mejor que DeepSeek V4.1 Flash?
No en todos los casos. Pro ofrece la búsqueda web integrada en Responses API y puede resultar útil en determinadas tareas complejas. Flash admite imágenes, ofrece mayor concurrencia y tiene tarifas inferiores. La elección debe basarse en pruebas con tu carga real.
¿Puede ejecutarse en una computadora normal?
No debe asumirse. El checkpoint completo es extremadamente grande y las necesidades dependen de precisión, cuantización, contexto y runtime. Las versiones cuantizadas de terceros pueden reducir los recursos, pero también pueden modificar calidad y compatibilidad.
¿Funciona en español?
Puede recibir y generar contenido en español, pero DeepSeek no publica en la documentación consultada una métrica específica para español latinoamericano. Evalúalo con prompts, terminología y formatos de tu propio proyecto.
¿Vale la pena utilizar DeepSeek V4 Pro?
DeepSeek V4 Pro sigue siendo una opción disponible para razonamiento, programación, agentes y flujos que necesitan búsqueda web integrada. Su contexto amplio, Thinking Mode, Tool Calls y compatibilidad con Responses API permiten construir sistemas complejos.
Sin embargo, no debe ser la elección automática. V4.1 Flash es más económico, admite imágenes y ofrece una concurrencia mayor. Prueba ambos modelos con las mismas tareas y elige según calidad, costo, latencia, uso de herramientas, privacidad y estabilidad.
Fuentes consultadas
- DeepSeek API Change Log.
- DeepSeek Models & Pricing.
- DeepSeek List Models.
- DeepSeek V4 Pro GA Release.
- DeepSeek V4 Preview.
- Model Card de DeepSeek-V4-Pro-0813.
- Documentación de Thinking Mode.
- Documentación de Tool Calls.
- Documentación de Responses API.
- Documentación de Search y Fetch.
- Política de privacidad de DeepSeek.
- Condiciones de DeepSeek Open Platform.