
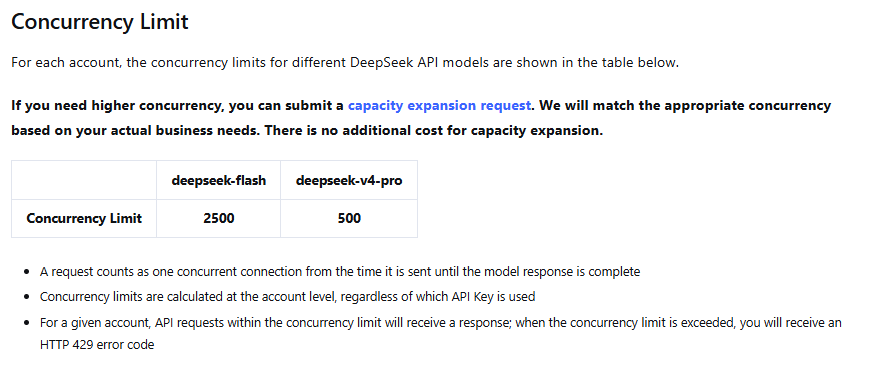
Para la inferencia de modelos, DeepSeek API publica límites de 2500 solicitudes simultáneas para deepseek-flash y 500 para deepseek-v4-pro. Son límites de concurrencia: no significan 2500 o 500 solicitudes por minuto.
Si recibes 429 Rate Limit Reached, el primer paso es identificar qué límite alcanzaste y qué servicio devolvió el error. La solución combina control de solicitudes activas, una cola de espera y reintentos limitados. Repetir la llamada inmediatamente puede aumentar la presión que causó el problema.
Cuáles son los límites actuales de DeepSeek API
La tabla oficial de modelos y la guía de Search y Fetch publican límites de distinta naturaleza:
| Modelo o API | Límite publicado | Qué se cuenta |
|---|---|---|
deepseek-flash | 2500 solicitudes simultáneas | Solicitudes de inferencia activas. |
deepseek-v4-pro | 500 solicitudes simultáneas | Solicitudes de inferencia activas. |
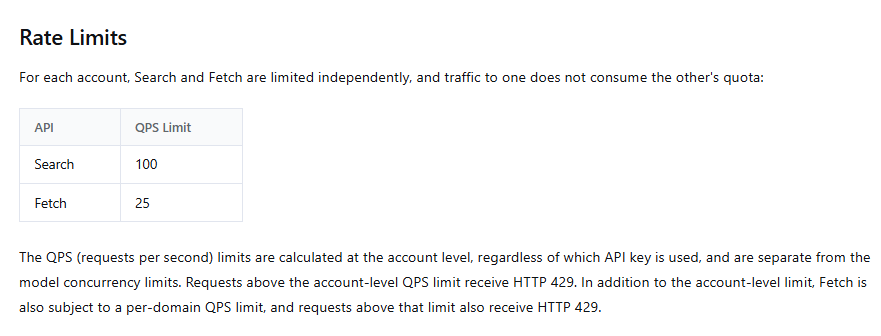
| Search API | 100 QPS | Solicitudes por segundo. |
| Fetch API | 25 QPS | Solicitudes por segundo. |
El límite de los modelos se calcula por cuenta, independientemente de la API key. Cada solicitud ocupa capacidad desde su envío hasta que termina la respuesta, según la documentación de límites.
Search y Fetch tienen límites independientes
Las cuotas de Search y Fetch se calculan por cuenta, son independientes entre sí y están separadas de la concurrencia de los modelos. Fetch también tiene un límite por dominio de destino, cuyo valor numérico no se indica en la guía.
Por eso, un 429 al consultar muchas páginas de un mismo sitio no se diagnostica únicamente mirando las llamadas activas a deepseek-flash. Identifica el endpoint que falló y aplica el control correspondiente.
Estos valores describen la API directa de DeepSeek. Si utilizas un intermediario o un proveedor que aloja sus modelos, comprueba sus propias cuotas y la procedencia del error. La compatibilidad con un formato de API no implica compartir los mismos límites.
Concurrencia, RPM, TPM y QPS: qué cambia en tu aplicación
Antes de configurar un limitador, identifica la unidad que debe controlar:
- Concurrencia: cuántas solicitudes permanecen activas al mismo tiempo.
- QPS: cuántas solicitudes se realizan por segundo.
- RPM: cuántas solicitudes se realizan por minuto.
- TPM: cuántos tokens se procesan por minuto.
Las páginas oficiales consultadas no presentan una tabla general de cuotas RPM o TPM para la inferencia directa. Tampoco debes confundir el tamaño de la ventana de contexto o el máximo de salida de un modelo con una cuota de tokens por minuto.
Un límite de concurrencia se recupera cuando terminan las solicitudes. No funciona como una bolsa de solicitudes que necesariamente se reinicia cada minuto. Y limitar las conexiones activas no impone por sí solo un QPS: si las respuestas son muy rápidas, puedes iniciar muchas llamadas consecutivas.
Ejemplo de cómo la duración cambia la capacidad
Supón que tu aplicación permite 12 solicitudes activas y que cada una tarda, en promedio, seis segundos en completarse. Bajo condiciones estables y con trabajo disponible, el ritmo aproximado sería:
12 solicitudes activas ÷ 6 segundos ≈ 2 solicitudes por segundo
2 solicitudes por segundo × 60 ≈ 120 solicitudes por minuto
Si la duración media sube a 12 segundos, el mismo grupo de 12 solicitudes permite completar aproximadamente una por segundo. Estos números son un ejemplo de planificación, no cuotas ni resultados de rendimiento de DeepSeek.
Mide la duración completa, no solo el tiempo hasta el primer token. Deja margen para variaciones y otras aplicaciones que usen la cuenta; configurar el máximo publicado como objetivo constante no garantiza una experiencia estable.
Cómo diagnosticar y resolver el error 429
La referencia oficial de errores relaciona el código 429 con solicitudes demasiado rápidas o con superar límites de concurrencia o QPS. Para encontrar la causa, sigue este orden:
- Identifica la ruta. Revisa el dominio, el endpoint y el modelo. Determina si la respuesta procede de la API directa, de una herramienta como Fetch o de un intermediario.
- Cuenta la actividad de toda la cuenta. Incluye servidores, tareas programadas, procesos en segundo plano y otras aplicaciones. Un contador dentro de una sola instancia puede mostrar solo una parte del tráfico.
- Busca solicitudes que siguen abiertas. Revisa respuestas largas, streams sin cerrar y llamadas que todavía esperan datos. Comprueba que tus contadores se liberan tanto al terminar como al fallar una tarea.
- Reduce la presión de entrada. Baja el número de llamadas activas y encola trabajo que pueda esperar. Para Search y Fetch, controla también el ritmo de inicio de solicitudes y el dominio consultado.
- Reintenta con límites. Introduce espera y variación aleatoria, fija un máximo de intentos y termina la tarea cuando se agote su presupuesto de tiempo.
Si hay más trabajo del que tu aplicación puede procesar, la cola también necesita un tamaño y un tiempo de espera máximos. Cuando se llenen, devuelve un estado claro de «intenta más tarde» o programa el trabajo para otro momento, según tu producto.
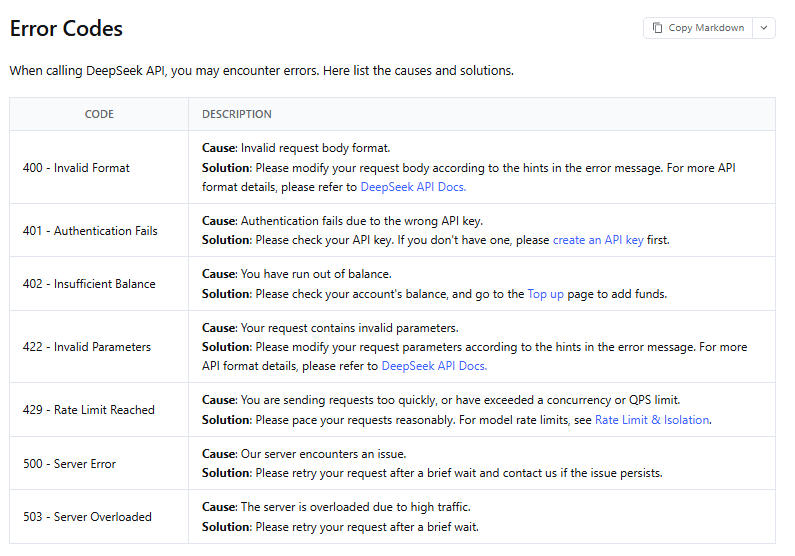
Distingue 429 de problemas de saldo, parámetros o servidor
| Código | Qué indica DeepSeek | Acción adecuada |
|---|---|---|
429 | Límite de solicitudes alcanzado. | Reducir presión y reintentar con espera limitada. |
402 | Saldo insuficiente. | Revisar el saldo; una espera automática no lo corrige. |
500 / 503 | Error del servidor o sobrecarga. | Esperar y aplicar reintentos limitados. |
400 / 422 | Formato o parámetros inválidos. | Corregir la solicitud antes de repetirla. |
401 | Fallo de autenticación. | Revisar la clave y su configuración. |
Un timeout de tu cliente es otra situación: puede ocurrir sin que hayas recibido un código HTTP. No lo etiquetes automáticamente como 429 ni supongas que confirma que el proveedor no procesó la solicitud.
Cómo implementar reintentos sin multiplicar la carga
El backoff exponencial aumenta la ventana de espera después de cada fallo. El jitter añade variación aleatoria para que varias solicitudes no vuelvan a intentarlo al mismo tiempo. La explicación técnica de AWS muestra por qué combinar ambas técnicas reduce la concentración de reintentos.
Si recibes un encabezado Retry-After válido, tenlo en cuenta. El estándar HTTP permite expresarlo como segundos o como una fecha HTTP. Su presencia es opcional en una respuesta 429; no presupongas que DeepSeek lo enviará siempre.
Si la espera indicada supera el tiempo disponible para tu tarea, detén el intento o programa el trabajo para más adelante. Reducir esa espera para cumplir un plazo local puede volver a presionar al servidor antes de lo que solicita.
También revisa si tu SDK, proxy o cola ya reintentan. Una capa que hace tres intentos dentro de otra que repite tres veces puede generar hasta nueve llamadas. Elige qué capa controla esa política y fija un presupuesto para el conjunto.
Ejemplo en Node.js: solicitudes limitadas y reintentos con espera
El siguiente ejemplo utiliza fetch y AbortSignal.timeout() de Node.js, sin paquetes externos. Envía solicitudes de texto sin streaming al endpoint de Chat Completions y solo acepta una respuesta con finish_reason: stop y contenido de texto.
Sus valores son decisiones educativas, no límites oficiales: dos tareas simultáneas, hasta tres intentos totales por tarea y 30 segundos desde que un trabajador empieza a procesarla. El tiempo que una tarea pasa esperando en la cola antes de eso no está incluido. Ajusta estas decisiones a las necesidades de tu aplicación.
Con Node.js 22 o posterior, guarda tu clave en un archivo .env del servidor. Mantén ese archivo fuera del repositorio y de cualquier directorio público:
DEEPSEEK_API_KEY=tu_clave_de_deepseekGuarda este código como limites-deepseek.mjs:
import { setTimeout as sleep } from "node:timers/promises";

const apiKey = process.env.DEEPSEEK_API_KEY;
if (!apiKey) throw new Error("Falta DEEPSEEK_API_KEY");

const WORKERS = 2, MAX_ATTEMPTS = 3, BUDGET_MS = 30_000;
const RETRYABLE = new Set([429, 500, 503]);

function retryAfterMs(value) {
  if (value === null) return 0;
  const raw = value.trim();
  if (/^\d+$/.test(raw)) return Number(raw) * 1000;
  const timestamp = Date.parse(raw);
  return Number.isFinite(timestamp)
    ? Math.max(0, timestamp - Date.now())
    : 0;
}

async function generate(prompt) {
  const signal = AbortSignal.timeout(BUDGET_MS);
  const deadline = performance.now() + BUDGET_MS;
  const body = JSON.stringify({
    model: "deepseek-flash",
    messages: [{ role: "user", content: prompt }],
    thinking: { type: "disabled" },
    max_tokens: 128,
    stream: false,
  });

  for (let attempt = 1; attempt <= MAX_ATTEMPTS; attempt++) {
    signal.throwIfAborted();
    const response = await fetch(
      "https://api.deepseek.com/chat/completions",
      {
        method: "POST",
        headers: {
          Authorization: `Bearer ${apiKey}`,
          "Content-Type": "application/json",
        },
        body,
        signal,
      },
    );
    const text = await response.text();
    signal.throwIfAborted();

    if (response.ok) {
      const data = JSON.parse(text);
      const choice = data?.choices?.[0];
      if (choice?.finish_reason !== "stop" ||
          typeof choice.message?.content !== "string" ||
          !choice.message.content.trim()) {
        throw new Error("Respuesta incompleta; revisa finish_reason");
      }
      return choice.message.content;
    }

    if (!RETRYABLE.has(response.status) || attempt === MAX_ATTEMPTS) {
      throw new Error(`HTTP ${response.status}; no se reintentará`);
    }
    const serverDelay = retryAfterMs(response.headers.get("Retry-After"));
    const jitter = Math.random() * Math.min(8000, 1000 * 2 ** (attempt - 1));
    const delay = serverDelay + jitter;
    if (delay >= deadline - performance.now()) {
      throw new Error("La espera supera el presupuesto de la tarea");
    }
    await sleep(delay, undefined, { signal });
  }
}

async function runLimited(prompts) {
  const results = new Array(prompts.length);
  let next = 0;
  async function worker() {
    while (next < prompts.length) {
      const index = next++;
      try {
        results[index] = { ok: true, text: await generate(prompts[index]) };
      } catch (error) {
        results[index] = { ok: false, error: error.message };
      }
    }
  }
  await Promise.all(
    Array.from({ length: Math.min(WORKERS, prompts.length) }, worker),
  );
  return results;
}

console.log(await runLimited([
  "Define una API en una frase.",
  "Define latencia en una frase.",
  "Explica qué es una cola de tareas en una frase.",
]));
Ejecútalo con:
node --env-file=.env limites-deepseek.mjsEl programa procesa tres consultas de ejemplo y devuelve un resultado o error para cada una. Al ejecutarlo se realizan llamadas reales a la API y se aplica su facturación por uso.
La política del ejemplo reintenta únicamente 429, 500 y 503. Una espera indicada por Retry-After recibe jitter adicional; si no cabe en el presupuesto restante, la tarea termina. La misma señal de tiempo máximo cubre la conexión, la lectura del cuerpo y las esperas entre intentos.
Los errores de red, los timeouts y las respuestas incompletas no se repiten automáticamente. Así, una interrupción de resultado incierto no dispara otra generación sin una decisión de la aplicación. Para este caso de texto sencillo, una salida terminada por length requiere revisar la longitud solicitada, no repetir ciegamente la misma llamada.
El control de reintentos, el tiempo máximo y la concurrencia de este ejemplo se verificaron con respuestas simuladas. Esa comprobación no mide la capacidad ni la latencia del servicio de DeepSeek.
Qué cambia cuando tienes varias instancias
El contador del ejemplo pertenece a un proceso. Si despliegas varias instancias, cada una ejecutará su propio grupo de trabajadores. Para coordinar la cuenta completa, utiliza un despachador central o un mecanismo compartido que limite el total de solicitudes activas.
Reserva capacidad para cada tipo de trabajo y evita que un lote en segundo plano ocupe todos los recursos de una función interactiva. En producción también necesitas controlar cuánto puede esperar cada tarea antes de empezar y cómo se elimina de la cola si el usuario ya no necesita el resultado.
Este ejemplo controla concurrencia de inferencia; no implementa un límite de QPS para Search o Fetch. Para esas APIs añade un control temporal de admisión de llamadas.
Qué ocurre con streaming, keep-alive y los tiempos de espera
En streaming, recibir el primer fragmento no significa que terminó la solicitud. Mantén su lugar ocupado en el contador hasta completar la lectura o cerrar el flujo; de lo contrario, tu aplicación puede subestimar su actividad.
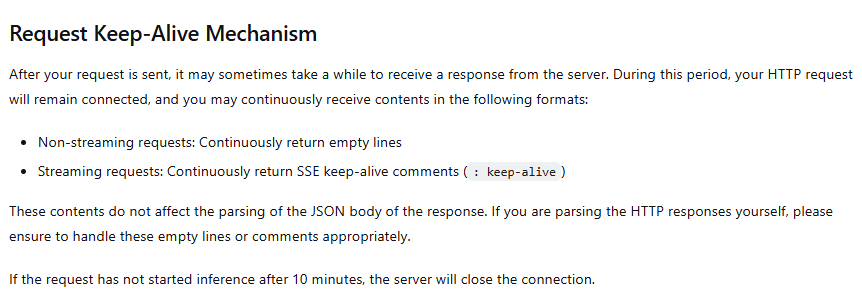
La documentación de keep-alive describe líneas vacías durante la espera sin streaming y comentarios SSE : keep-alive durante el streaming. Esas señales mantienen la conexión, pero no son texto generado para el usuario.
DeepSeek también indica que cierra la conexión si la inferencia no ha empezado después de 10 minutos. Ese umbral no es un máximo general de duración de todas las respuestas.
Tu aplicación puede tener un plazo más corto, como los 30 segundos del ejemplo. En ese caso, el cliente puede cancelar una solicitud que seguía esperando válidamente en el servidor. Elige el plazo según el tipo de tarea y recuerda que abortar localmente no certifica que todo procesamiento remoto se haya detenido.
Si un stream se interrumpe después de mostrar texto, no añadas automáticamente una nueva respuesta al contenido anterior como si fuera una continuación garantizada. Decide si presentar el resultado parcial, permitir un nuevo intento o reiniciar la tarea de forma explícita.
Además, revisa finish_reason. El contrato de Chat Completions contempla finales como length, insufficient_system_resource y aborted. Un HTTP exitoso por sí solo no confirma que se obtuvo una respuesta completa para tu caso de uso.
Cómo solicitar más capacidad
DeepSeek permite solicitar más concurrencia para los modelos desde su página de límites, según las necesidades del negocio y sin cargo adicional por la ampliación. La API mantiene su facturación por uso.
Antes de solicitarla, reúne información que permita distinguir crecimiento real de problemas de integración:
- Modelo y carga: identifica qué modelo necesita más solicitudes simultáneas y para qué tareas.
- Demanda observada: registra solicitudes activas, ritmo de entrada y duración completa de las respuestas.
- Errores y colas: mide la frecuencia de 429, el tiempo de espera y cuántas tareas abandonan la cola.
- Distribución del trabajo: identifica picos, procesos en segundo plano y número de instancias.
- Necesidad del producto: explica qué experiencia o plazo no puedes cumplir con la capacidad actual.
Qué cambia con las API keys y user_id
Crear otra clave dentro de la misma cuenta no añade una cuota independiente. En cuentas normales, las solicitudes de todos los valores de user_id se cuentan conjuntamente; con ampliación existen controles tanto de cuenta como por user_id.
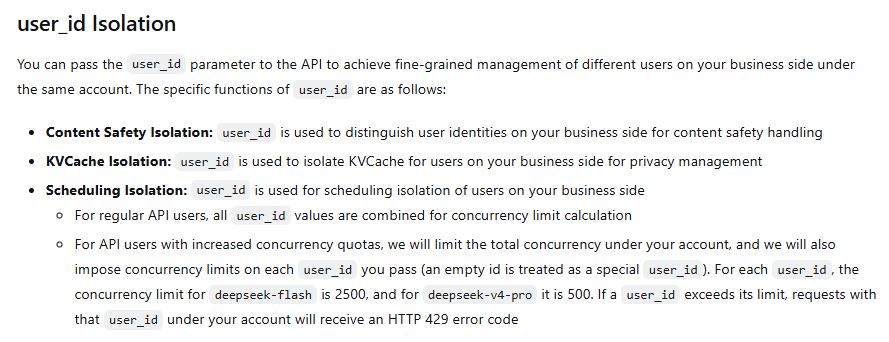
Por eso, una solicitud de más capacidad debe aclarar cómo se reparte el uso entre usuarios o cargas de trabajo. user_id sirve para identificar y aislar tráfico conforme al servicio; no debe tratarse como un recurso para multiplicar artificialmente el límite.
Conserva los límites aprobados junto con la configuración de tu sistema y revisa las métricas después de cada cambio. Aumentar capacidad será útil si la aplicación también controla las colas, las solicitudes que siguen abiertas y el número total de intentos.
Última verificación de las fuentes: 10 de noviembre de 2026.