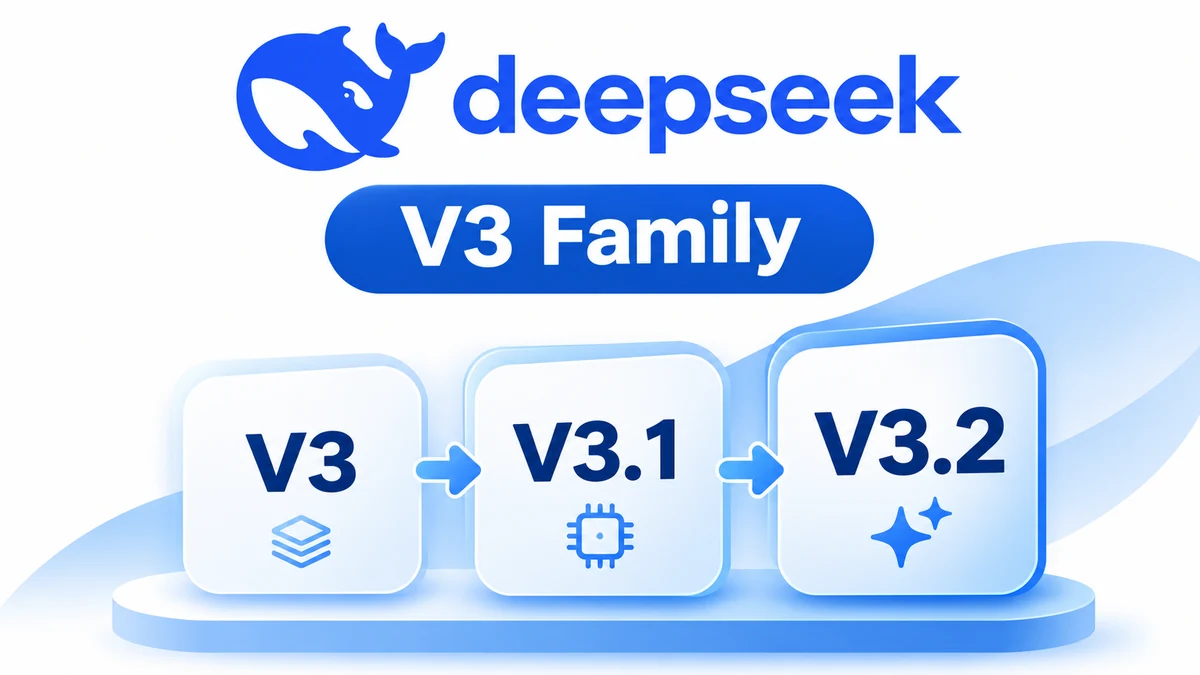

DeepSeek V3 Family no es el nombre de un único modelo ni de un producto actual de la API. Es una forma práctica de agrupar la línea que comenzó con DeepSeek-V3 y continuó con actualizaciones como V3-0324, V3.1, V3.1-Terminus, V3.2-Exp y V3.2.
Estas versiones comparten una línea técnica, pero no son intercambiables. Algunas son checkpoints base, otras están preparadas para conversación, algunas admiten razonamiento y herramientas, y varias ya no aparecen entre los modelos alojados actualmente por la API oficial aunque sus pesos sigan disponibles para descarga.
Información verificada el 10 de noviembre de 2026.
Qué significa DeepSeek V3 Family
DeepSeek no presenta “DeepSeek V3 Family” como un producto único con una ficha propia. En este artículo, el término familia DeepSeek V3 se utiliza como una categoría editorial para reunir los checkpoints y actualizaciones oficiales que forman parte directa de la línea V3.
Para incluir un modelo dentro de esta familia se aplican cuatro criterios: fue publicado por la cuenta oficial de DeepSeek, su nombre pertenece a la línea V3, existe un anuncio o model card oficial y su relación con el checkpoint anterior está documentada.
- Sí pertenecen a la línea: DeepSeek-V3, V3-0324, V3.1, V3.1-Terminus, V3.2-Exp, V3.2 y sus variantes Base o Speciale oficiales.
- No pertenecen automáticamente: DeepSeek-R1, los modelos R1-Distill, DeepSeek-V4, DeepSeek-Coder, DeepSeek-Math, DeepSeek-OCR y los modelos visuales.
- Tampoco son versiones oficiales nuevas: cuantizaciones, fine-tunes o derivados publicados por terceros, aunque conserven “DeepSeek V3” en el nombre.
Modelos oficiales que forman parte de la familia DeepSeek V3
| Modelo | Tipo | Función dentro de la familia |
|---|---|---|
DeepSeek-V3-Base | Base | Checkpoint de preentrenamiento original para investigación, adaptación y postentrenamiento. |
DeepSeek-V3 | Postentrenado | Primera versión general preparada para seguir instrucciones y mantener conversaciones. |
DeepSeek-V3-0324 | Actualización postentrenada | Mejora el modelo conversacional utilizando el mismo modelo base que V3. |
DeepSeek-V3.1-Base | Base con contexto extendido | Continúa el preentrenamiento de la base original y sirve como fundamento de V3.1. |
DeepSeek-V3.1 | Postentrenado híbrido | Integra modos de pensamiento y respuesta directa en el mismo modelo. |
DeepSeek-V3.1-Terminus | Actualización postentrenada | Refina V3.1 para mejorar consistencia lingüística y tareas de agentes. |
DeepSeek-V3.2-Exp-Base | Base experimental | Checkpoint base oficial de la rama que incorpora DeepSeek Sparse Attention. |
DeepSeek-V3.2-Exp | Experimental | Valida una arquitectura de atención dispersa más eficiente para contexto largo. |
DeepSeek-V3.2 | Postentrenado estable | Sucesor general de V3.2-Exp, orientado al razonamiento y al uso de herramientas. |
DeepSeek-V3.2-Speciale | Variante especializada | Se centra en razonamiento profundo y no admite tool calling. |
No existe un repositorio separado llamado DeepSeek-V3.2-Base dentro del árbol oficial consultado. El model card de V3.2 identifica DeepSeek-V3.2-Exp-Base como su modelo base, por lo que no conviene inventar una variante intermedia por analogía con V3 o V3.1.
Cronología de DeepSeek V3
| Fecha | Versión | Cambio principal |
|---|---|---|
| 26 de diciembre de 2024 | DeepSeek-V3 | Presentación de la arquitectura MoE original y publicación de los pesos y el informe técnico. |
| 25 de marzo de 2025 | DeepSeek-V3-0324 | Actualización del postentrenamiento con mejoras en razonamiento, código, escritura y herramientas. |
| 21 de agosto de 2025 | DeepSeek-V3.1 | Incorpora razonamiento híbrido, contexto extendido y mejores capacidades para agentes. |
| 22 de septiembre de 2025 | DeepSeek-V3.1-Terminus | Corrige inconsistencias lingüísticas y mejora Code Agent y Search Agent. |
| 29 de septiembre de 2025 | DeepSeek-V3.2-Exp | Introduce DeepSeek Sparse Attention como experimento de eficiencia para contexto largo. |
| 1 de diciembre de 2025 | DeepSeek-V3.2 | Convierte la rama experimental en un sucesor estable con razonamiento durante el uso de herramientas. |
| 1 de diciembre de 2025 | DeepSeek-V3.2-Speciale | Publica una variante especializada en razonamiento intensivo, sin soporte para herramientas. |
Las fechas de esta tabla corresponden a los anuncios de lanzamiento. No deben confundirse con la fecha en que se actualizó un archivo en Hugging Face, se modificó el alias de una API o se retiró un endpoint temporal.
DeepSeek-V3 y V3-Base: el punto de partida
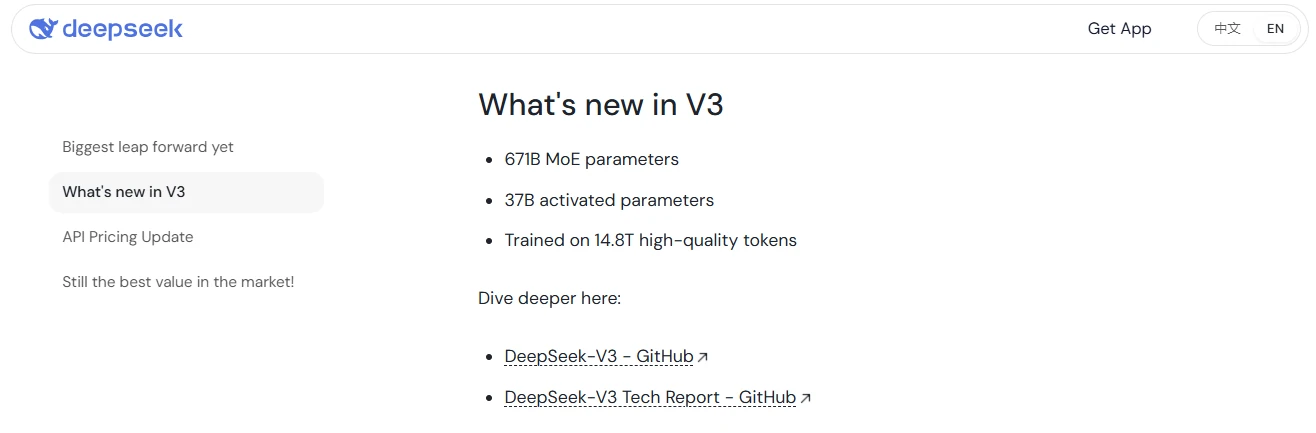
DeepSeek-V3 fue presentado como un modelo Mixture of Experts, o mezcla de expertos. La documentación original describe 671 mil millones de parámetros totales, de los cuales 37 mil millones se activan para procesar cada token.
Esto no significa que sea un modelo pequeño. Los parámetros que no se activan para un token concreto siguen formando parte de los pesos que deben almacenarse y distribuirse durante una implementación completa.
La arquitectura original también utiliza Multi-head Latent Attention para reducir el costo asociado al caché de atención y Multi-Token Prediction como parte de su estrategia de entrenamiento. El modelo fue entrenado con 14.8 billones de tokens, de acuerdo con el anuncio oficial de DeepSeek-V3.
Diferencia entre DeepSeek-V3-Base y DeepSeek-V3
DeepSeek-V3-Base es el checkpoint de preentrenamiento. Está pensado para investigación, continued pretraining, fine-tuning y desarrollo de variantes propias. No debe tratarse automáticamente como un asistente conversacional terminado.
DeepSeek-V3 añade postentrenamiento para seguir instrucciones y responder en formato de conversación. Para un chat o una aplicación orientada a usuarios, esta diferencia es más importante que compartir la misma arquitectura base.
Qué cambió en DeepSeek-V3-0324
DeepSeek-V3-0324 no reemplazó la arquitectura base de V3. El anuncio oficial indica que utiliza el mismo base model y cambia principalmente el postentrenamiento.
- Mejor rendimiento en tareas de razonamiento sin convertirse en un modelo R1.
- Mejoras en desarrollo front-end y generación de código HTML.
- Mayor calidad de escritura, especialmente en chino.
- Mejor uso de herramientas, conversación y seguimiento de instrucciones.
- Actualización del tokenizer y del formato relacionado con tool calls.
Esta versión es importante también por su licencia. El anuncio oficial de V3-0324 especifica que los pesos se publicaron bajo MIT, mientras que el repositorio de la versión V3 original diferenciaba entre la licencia MIT del código y una Model License separada para los modelos.
DeepSeek-V3.1: razonamiento híbrido y agentes
DeepSeek-V3.1 marcó uno de los cambios funcionales más importantes de la familia. Un mismo modelo puede trabajar en modo thinking y non-thinking mediante cambios en el template de conversación.
El modo thinking dedica más procesamiento al razonamiento antes de entregar la respuesta final. El modo non-thinking prioriza una respuesta más directa. Esto evita tener que mantener dos familias de pesos completamente independientes para ambos comportamientos.
La versión base de V3.1 se construyó mediante continued pretraining sobre la base original de V3. DeepSeek informó 840 mil millones de tokens adicionales distribuidos entre las fases de extensión de contexto.
- Razonamiento y respuesta directa en el mismo checkpoint postentrenado.
- Mejor desempeño en tool use y tareas de agentes con varios pasos.
- Nuevo tokenizer y chat template.
- Publicación de
DeepSeek-V3.1-BaseyDeepSeek-V3.1como pesos oficiales. - Compatibilidad histórica con formatos OpenAI y Anthropic en la API alojada.
El anuncio de la API describía un contexto de 128K. Sin embargo, el archivo config.json de los checkpoints oficiales utiliza max_position_embeddings: 163840. Las dos cifras no deben mezclarse: una puede describir el límite ofrecido por el servicio alojado y la otra la configuración máxima del checkpoint.
Qué es DeepSeek-V3.1-Terminus
DeepSeek-V3.1-Terminus es una actualización de V3.1, no una nueva base arquitectónica. Se publicó para corregir problemas observados después del lanzamiento original.
- Reduce mezclas no deseadas entre chino e inglés.
- Disminuye la aparición de caracteres inesperados.
- Mejora el rendimiento de Code Agent.
- Refuerza Search Agent y tareas de búsqueda con varios pasos.
- Mantiene como base oficial
DeepSeek-V3.1-Base.
Para una implementación histórica basada en V3.1, Terminus suele ser el checkpoint más lógico que se debe evaluar porque incorpora las correcciones posteriores. Esto no significa que sea la mejor elección para un producto nuevo que dependa de la API oficial actual.
DeepSeek-V3.2-Exp y DeepSeek Sparse Attention
DeepSeek-V3.2-Exp fue una versión experimental construida sobre V3.1-Terminus. Su objetivo principal no era crear una familia completamente distinta, sino probar DeepSeek Sparse Attention, conocida como DSA.
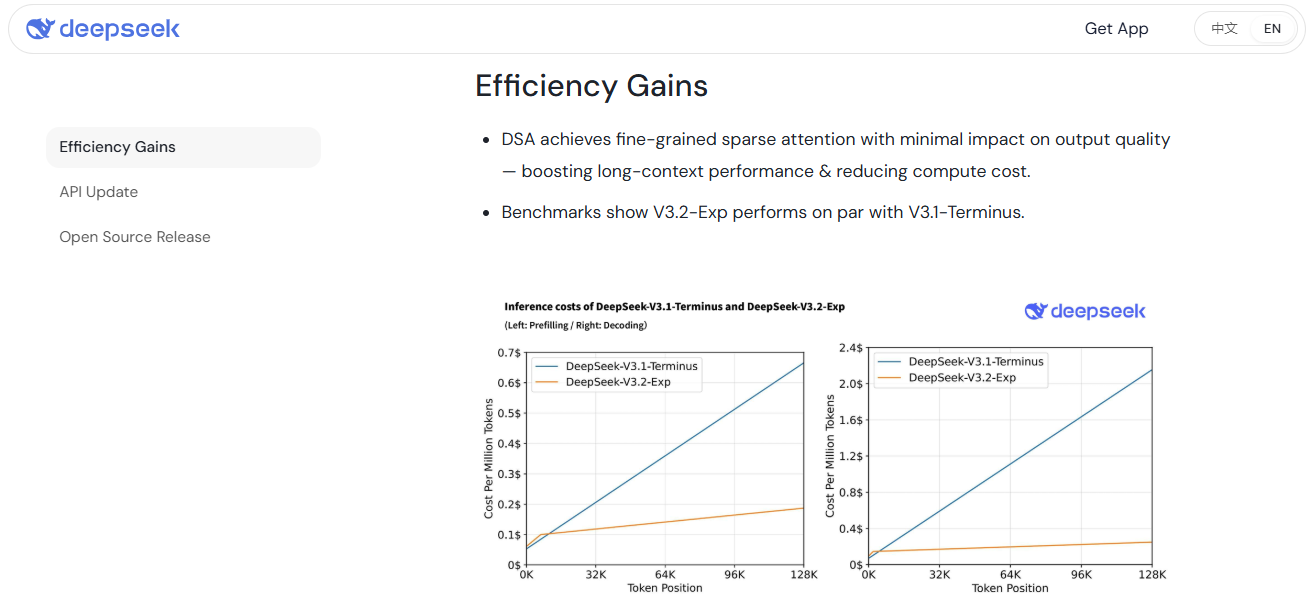
La atención convencional compara cada token nuevo con una cantidad creciente de tokens anteriores. DSA utiliza un indexador para seleccionar un subconjunto relevante antes de ejecutar la atención principal, reduciendo el trabajo necesario en secuencias largas.
En la configuración oficial, el mecanismo utiliza index_topk: 2048. Esto significa que la atención principal puede concentrarse en un número seleccionado de posiciones en lugar de operar de la misma forma sobre toda la secuencia disponible.
DeepSeek presentó V3.2-Exp como un paso intermedio para validar eficiencia de entrenamiento e inferencia. Por esa razón, no debe confundirse con la versión estable posterior ni recomendarse automáticamente para una nueva implementación.
DeepSeek-V3.2 y V3.2-Speciale
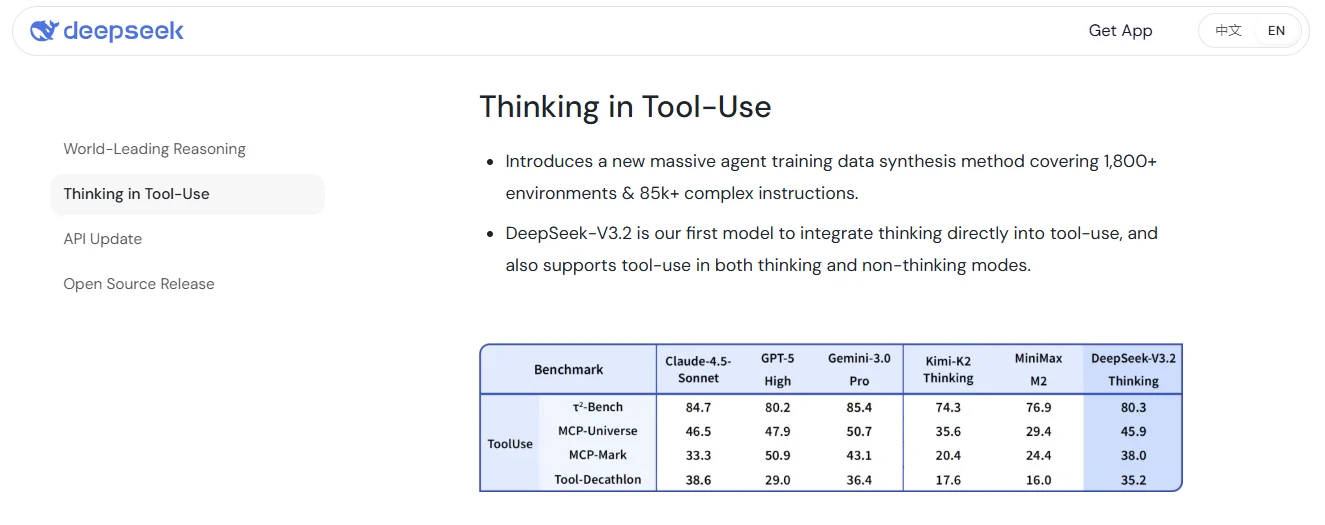
DeepSeek-V3.2 es el sucesor estable de V3.2-Exp. Conserva DeepSeek Sparse Attention y añade un postentrenamiento más orientado al razonamiento, los agentes y el uso de herramientas.
Su cambio práctico más importante es la capacidad de razonar mientras utiliza herramientas. DeepSeek indicó que V3.2 admite tool use tanto en modo thinking como en modo non-thinking.
Para qué sirve V3.2-Speciale
DeepSeek-V3.2-Speciale es una variante especializada en razonamiento intensivo. No es el reemplazo general de V3.2 y no admite tool calling.
En su lanzamiento, Speciale estuvo disponible mediante un endpoint temporal de la API hasta el 15 de diciembre de 2025. Ese endpoint no debe utilizarse en código nuevo. Los pesos oficiales continúan disponibles en Hugging Face bajo licencia MIT.
| Versión | Razonamiento | Herramientas | Uso principal |
|---|---|---|---|
| V3 | No ofrece el modo híbrido posterior | Funciones básicas según la implementación | Conversación general y estudio de la arquitectura original. |
| V3-0324 | Razonamiento mejorado mediante postentrenamiento | Tool use mejorado | Versión conversacional refinada de la primera rama. |
| V3.1 | Thinking y non-thinking | Mejor soporte para agentes | Razonamiento híbrido y tareas con varios pasos. |
| V3.1-Terminus | Thinking y non-thinking | Code Agent y Search Agent mejorados | Implementaciones de V3.1 que necesitan mayor estabilidad. |
| V3.2-Exp | Hereda el enfoque híbrido de la rama | Evaluación experimental de agentes | Investigación sobre DSA y eficiencia en contexto largo. |
| V3.2 | Thinking y non-thinking | Razonamiento durante tool use | Agentes, código, búsqueda y razonamiento con pesos abiertos. |
| V3.2-Speciale | Especializado en razonamiento profundo | No admite tool calling | Investigación y problemas de razonamiento intensivo. |
Comparación de las principales versiones
| Versión | Base o postentrenada | Cambio principal | Pesos oficiales | Disponibilidad actual en la API oficial |
|---|---|---|---|---|
| V3-Base | Base | Arquitectura MoE original | Sí | No aparece como modelo alojado actual |
| V3 | Postentrenada | Primera versión conversacional | Sí | No aparece como modelo alojado actual |
| V3-0324 | Postentrenada | Mejora de razonamiento, código y herramientas | Sí | No aparece como modelo alojado actual |
| V3.1-Base | Base | Continued pretraining y contexto extendido | Sí | No aparece como modelo alojado actual |
| V3.1 | Postentrenada | Thinking y non-thinking en un modelo | Sí | No aparece como modelo alojado actual |
| V3.1-Terminus | Postentrenada | Consistencia lingüística y agentes | Sí | No aparece como modelo alojado actual |
| V3.2-Exp | Experimental | DeepSeek Sparse Attention | Sí | Reemplazado por V3.2 |
| V3.2 | Postentrenada | Razonamiento durante tool use | Sí | No aparece como modelo alojado actual |
| V3.2-Speciale | Especializada | Razonamiento intensivo sin herramientas | Sí | El endpoint temporal expiró |
“No aparece como modelo alojado actual” no significa que el checkpoint haya desaparecido. Significa que no figura entre los model IDs mostrados en la documentación vigente de la API de DeepSeek.
DeepSeek V3 en la API: nombres históricos y situación actual
Uno de los errores más frecuentes es tratar un alias de API como si fuera el nombre permanente de un checkpoint. El modelo servido detrás de un alias puede cambiar sin que el cliente modifique su código.
Durante el lanzamiento de V3.1, la documentación indicaba:
deepseek-chat: V3.1 en modo non-thinking.deepseek-reasoner: V3.1 en modo thinking.
V3.2 mantuvo inicialmente un patrón de uso compatible. Sin embargo, la página actual de Models & Pricing documenta deepseek-flash y deepseek-v4-pro, ambos pertenecientes al ciclo V4.
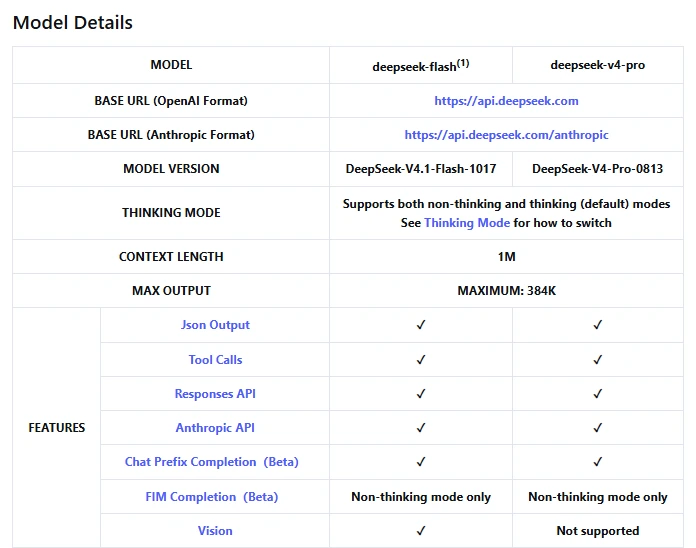
Por tanto, un proyecto nuevo no debe utilizar deepseek-chat, deepseek-reasoner ni el endpoint temporal de Speciale basándose en un tutorial antiguo. Primero debe consultar List Models o la página actual de modelos de DeepSeek.
Pesos abiertos y ejecución local
Los checkpoints principales de la familia siguen publicados en la cuenta verificada deepseek-ai en Hugging Face. Esto permite descargarlos, inspeccionarlos y desplegarlos en infraestructura propia.
“Disponible para descargar” no significa “fácil de ejecutar en una computadora convencional”. Los modelos completos se encuentran en la escala de cientos de miles de millones de parámetros, y las instrucciones oficiales recurren a paralelismo y motores de inferencia preparados para múltiples aceleradores.
- Pesos oficiales: publicados por
deepseek-ai. - Cuantización: versión que reduce precisión y memoria; puede ser oficial o comunitaria.
- Fine-tune: modelo modificado mediante entrenamiento adicional.
- Proveedor de inferencia: empresa externa que aloja el modelo y define su propio model ID.
- Despliegue local: ejecución en infraestructura administrada por el usuario, no necesariamente en una sola computadora.
Hugging Face puede mostrar una sección de cuantizaciones relacionadas con el modelo. Esa lista no convierte cada repositorio en una publicación oficial de DeepSeek. Verifica siempre el propietario del repositorio, la precisión, el formato y las modificaciones realizadas.
Licencias de la familia DeepSeek V3
No conviene atribuir una única licencia a todas las versiones sin revisar cada repositorio.
- DeepSeek-V3 original: el repositorio de código utiliza MIT, mientras que los modelos Base y Chat estaban sujetos a una Model License separada que permitía uso comercial.
- DeepSeek-V3-0324: el anuncio oficial indica que los pesos se publicaron bajo MIT.
- V3.1, V3.1-Base y V3.1-Terminus: sus repositorios oficiales de Hugging Face muestran licencia MIT.
- V3.2-Exp, V3.2 y V3.2-Speciale: los repositorios oficiales también indican MIT.
La licencia MIT permite un uso amplio, incluido el comercial, pero mantiene condiciones como conservar el aviso de copyright y la licencia. Esto no sustituye una revisión jurídica del checkpoint, el código, los datasets propios, los proveedores y la jurisdicción aplicable a tu proyecto.
Qué versión de DeepSeek V3 elegir
| Necesidad | Versión que conviene evaluar | Por qué |
|---|---|---|
| Estudiar la arquitectura original | V3-Base y V3 | Representan el punto de partida documentado en el informe técnico original. |
| Reproducir la experiencia conversacional inicial | V3-0324 | Conserva la base de V3 e incorpora un postentrenamiento más refinado. |
| Investigar continued pretraining | V3.1-Base | Extiende la base original con más entrenamiento para contexto largo. |
| Combinar razonamiento y respuesta directa | V3.1-Terminus | Ofrece los dos modos e incorpora correcciones posteriores a V3.1. |
| Estudiar atención dispersa | V3.2-Exp-Base o V3.2-Exp | Fueron publicados para validar DeepSeek Sparse Attention. |
| Crear agentes con pesos V3 abiertos | V3.2 | Es el sucesor estable y admite razonamiento durante el uso de herramientas. |
| Investigar razonamiento intensivo sin herramientas | V3.2-Speciale | Está especializado en razonamiento, pero no admite tool calling. |
| Construir hoy con la API oficial alojada | Revisar la generación V4 actual | Los modelos V3 no aparecen en la lista oficial vigente de model IDs. |
La versión con el número más alto no es siempre la elección adecuada. Una investigación sobre arquitectura base necesita un checkpoint Base, mientras que una aplicación con agentes necesita un modelo postentrenado y soporte real para herramientas.
DeepSeek V3, R1 y V4 no son la misma familia
Relación entre V3 y DeepSeek-R1
DeepSeek-R1 es una familia centrada en razonamiento. Puede compartir componentes, conocimientos o procesos de entrenamiento con modelos V3, pero no debe incluirse automáticamente en una tabla de versiones V3.x.
V3-0324, por ejemplo, incorporó técnicas aprendidas durante el entrenamiento de R1. Eso no convierte a V3-0324 en R1 ni significa que sus modos de uso sean idénticos.
Relación entre V3 y DeepSeek-V4
DeepSeek-V4 es una generación posterior. El Transparency Center de DeepSeek separa V3.2, publicado en diciembre de 2025, de V4, presentado en abril de 2026.
La existencia de características similares, como razonamiento, contexto largo o agentes, no convierte a V4 en una versión V3.3. Para proyectos que dependen de la API oficial actual, la generación V4 es la referencia vigente; para investigación y self-hosting, los checkpoints V3 continúan siendo relevantes.
Checklist antes de utilizar un modelo V3
- Confirma el nombre exacto del checkpoint.
- Verifica que el repositorio pertenezca a la cuenta oficial
deepseek-ai. - Distingue entre Base, postentrenado, experimental y especializado.
- Revisa si necesitas thinking, non-thinking o ambos.
- Comprueba si el modelo admite tool calling.
- No confundas la longitud del checkpoint con el límite de una API alojada.
- Revisa la licencia del repositorio concreto.
- Calcula infraestructura según precisión, contexto y motor de inferencia.
- Identifica si la cuantización es oficial o comunitaria.
- Consulta la lista actual de modelos antes de escribir código para la API.
- No reutilices precios, endpoints o aliases de un anuncio antiguo.
- Prueba el chat template y el formato de herramientas de la versión elegida.
Preguntas frecuentes
¿DeepSeek V3 Family es un nombre oficial?
No aparece como un producto único en la documentación oficial consultada. Es una forma útil de referirse a la línea de modelos y checkpoints V3 publicados por DeepSeek.
¿Cuál es la última versión de la línea V3?
DeepSeek-V3.2 es el sucesor general y estable de V3.2-Exp. V3.2-Speciale fue publicado al mismo tiempo como una variante especializada en razonamiento, no como reemplazo general para todos los usos.
¿DeepSeek V3 sigue disponible en la API oficial?
Las versiones V3 no aparecen en la página actual de modelos admitidos por la API. La documentación vigente muestra deepseek-flash y deepseek-v4-pro, pertenecientes a la generación V4. Los pesos V3 continúan disponibles para descarga y pueden existir en proveedores externos.
¿Puedo ejecutar DeepSeek V3 localmente?
Sí, los repositorios oficiales incluyen pesos e instrucciones de inferencia. Sin embargo, los modelos completos son muy grandes y normalmente requieren infraestructura con varios aceleradores, paralelismo y un motor compatible. No existe un requisito universal de VRAM válido para todas las precisiones y contextos.
¿Las cuantizaciones de DeepSeek V3 son oficiales?
No necesariamente. Hugging Face puede enlazar cuantizaciones creadas por la comunidad. Revisa el propietario del repositorio y no atribuyas una versión GGUF, AWQ, GPTQ o de otro formato a DeepSeek salvo que la cuenta oficial la haya publicado.
¿Cuál es la diferencia entre un modelo Base y uno de chat?
El modelo Base contiene el resultado del preentrenamiento y sirve como fundamento para adaptación o investigación. El modelo postentrenado añade seguimiento de instrucciones, conversación y, según la versión, razonamiento o herramientas.
¿DeepSeek-R1 pertenece a DeepSeek V3 Family?
No debe tratarse como una versión V3.x. Es una línea centrada en razonamiento que tiene relaciones técnicas e históricas con V3, pero mantiene su propia identidad y sus propios checkpoints.
¿Qué versión conviene para programación y agentes?
Entre los pesos abiertos de la línea V3, V3.2 es la opción más completa que se debe evaluar para razonamiento y tool use. Para un producto nuevo que utilizará la API oficial alojada, primero revisa los modelos V4 disponibles actualmente.
¿Se puede usar comercialmente?
El repositorio original de V3 indicaba que sus modelos permitían uso comercial bajo una Model License separada. V3-0324 y los principales repositorios V3.1 y V3.2 muestran licencia MIT. Revisa siempre el archivo de licencia del checkpoint específico antes de distribuirlo o integrarlo.
Fuentes oficiales consultadas
- Transparency Center de DeepSeek: generaciones, fechas y model cards principales.
- Anuncio oficial de DeepSeek-V3: arquitectura, parámetros y entrenamiento.
- Lanzamiento de DeepSeek-V3-0324: mejoras, pesos y licencia.
- Lanzamiento de DeepSeek-V3.1: razonamiento híbrido, agentes y modelos Base.
- Anuncio de DeepSeek-V3.1-Terminus: consistencia lingüística y agentes.
- Anuncio de DeepSeek-V3.2-Exp: DeepSeek Sparse Attention y estado experimental.
- Lanzamiento de DeepSeek-V3.2 y V3.2-Speciale: razonamiento, herramientas y disponibilidad inicial.
- Modelos actuales de la API de DeepSeek: model IDs y generación alojada vigente.
- Colecciones oficiales de DeepSeek en Hugging Face: checkpoints Base y postentrenados.
- Repositorio oficial de DeepSeek-V3: inferencia, pesos, informe técnico y licencias.