
DeepSeek Coder es una familia de modelos especializados en programación, no una extensión de código ni un único modelo actual de la API. Sus checkpoints originales y DeepSeek-Coder-V2 continúan disponibles para descarga, pero el servicio alojado de DeepSeek utiliza actualmente modelos generales más recientes con capacidades avanzadas de programación.
A fecha del 10 de noviembre de 2026, deepseek-coder no aparece entre los identificadores vigentes de la API oficial. Para una integración nueva, DeepSeek publica deepseek-flash y deepseek-v4-pro. Si quieres ejecutar específicamente un modelo Coder, debes utilizar sus pesos abiertos, una conversión local o un proveedor que identifique claramente el checkpoint.
La ruta adecuada depende de lo que necesites: conversar sobre código, completar una función mediante FIM, ejecutar un modelo local, integrar una API o permitir que un agente modifique archivos y ejecute pruebas. Cada opción utiliza componentes distintos y presenta riesgos diferentes.
Modelos, repositorios, API, FIM, integraciones y documentación verificados el 10 de noviembre de 2026.
Qué opción de DeepSeek elegir para programar
| Objetivo | Ruta recomendada | Qué utilizas realmente |
|---|---|---|
| Hacer una pregunta de programación sin instalar nada | Web o aplicación oficial | El modelo actual del servicio, no el DeepSeek Coder original |
| Integrar DeepSeek en una aplicación nueva | API oficial | deepseek-flash o deepseek-v4-pro |
| Completar código entre un inicio y un final | FIM Completion | deepseek-flash mediante el endpoint beta |
| Ejecutar DeepSeek Coder en una computadora | Hugging Face, Ollama u otro runtime local | Un checkpoint Coder o Coder-V2 específico |
| Conversar con un modelo Coder local | DeepSeek-Coder-V2-Lite-Instruct | La variante Instruct de 16B totales y 2.4B activos |
| Experimentar con autocompletado o FIM local | Una variante Base | DeepSeek Coder Base o Coder-V2-Lite-Base |
| Revisar y modificar un repositorio desde la terminal | Codex, Claude Code u OpenCode con DeepSeek | Un coding agent que utiliza los modelos actuales de la API |
| Probar una plataforma de agentes extensible | DeepSeek Harness | Software en developer preview capaz de usar herramientas y plugins |
No necesitas descargar DeepSeek-Coder-V2 solo para pedir una explicación o generar una función. El modelo alojado actual resulta más sencillo para la mayoría de las consultas. La instalación local tiene sentido cuando necesitas un checkpoint concreto, mayor control de la inferencia, trabajo sin conexión o procesamiento dentro de tu propia infraestructura.
Qué es DeepSeek Coder
DeepSeek Coder es una familia de modelos de lenguaje entrenada específicamente para trabajar con código y texto relacionado con programación. Puede generar funciones, explicar fragmentos, completar partes faltantes, proponer pruebas, detectar errores y ayudar a reorganizar código.
El modelo no ejecuta el código por sí mismo. Solo produce texto. Para compilar, correr pruebas, modificar archivos o ejecutar comandos necesitas conectarlo con un runtime, un editor, una aplicación o un coding agent que disponga de esas herramientas.
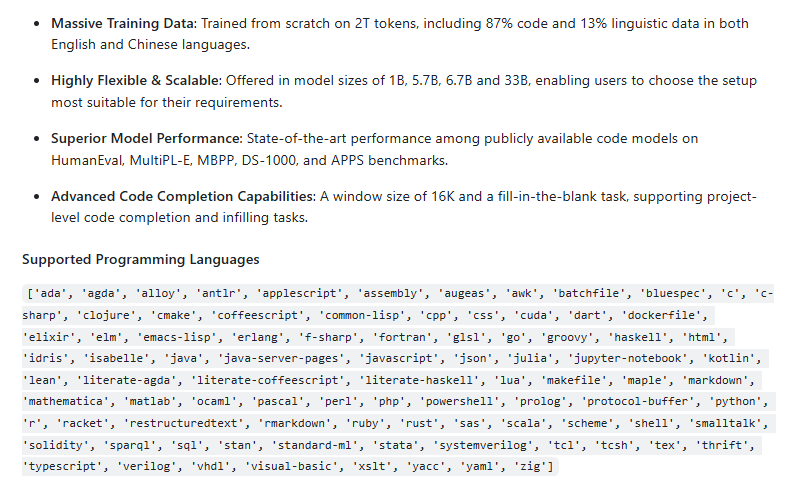
El repositorio oficial de DeepSeek Coder indica que la familia original se entrenó desde cero con 2 billones de tokens, compuestos por 87 % de código y 13 % de lenguaje natural en inglés y chino. También incorporó entrenamiento a nivel de repositorio, una ventana de 16K y una tarea de rellenado para completar código dentro de archivos existentes.
DeepSeek Coder original y Coder-V2 no son lo mismo
| Característica | DeepSeek Coder original | DeepSeek-Coder-V2 |
|---|---|---|
| Arquitectura | Modelos densos y una variante MQA | Mixture of Experts |
| Tamaños publicados | 1.3B, 5.7B, 6.7B y 33B | 16B y 236B totales |
| Parámetros activos | Dependen del modelo; no se aplica la misma estructura MoE de V2 | 2.4B en Lite y 21B en la versión completa |
| Contexto documentado | 16K | 128K |
| Lenguajes de programación declarados | 86 en la lista oficial | 338 |
| Entrenamiento | 2 billones de tokens | 6 billones de tokens adicionales desde un checkpoint de DeepSeek-V2 |
| Variantes principales | Base e Instruct | Lite-Base, Lite-Instruct, Base e Instruct |
| Uso más razonable actualmente | Pruebas ligeras, investigación y compatibilidad | Experimentación local más capaz y evaluación de modelos de código |
La cantidad de parámetros activos no equivale al tamaño completo del modelo. DeepSeek-Coder-V2-Lite activa alrededor de 2.4B parámetros durante el procesamiento, pero conserva 16B parámetros totales. Por eso, no debe calcularse su memoria como si fuera un modelo denso de 2.4B.
Modelos de la familia DeepSeek Coder original
La colección original contiene diferentes tamaños y no todas las variantes disponen de la misma versión Base e Instruct.
| Tamaño | Base | Instruct | Uso orientativo |
|---|---|---|---|
| 1.3B | Disponible | Disponible | Pruebas ligeras y aprendizaje del flujo local |
| 5.7B MQA | Disponible | No figura como lanzamiento oficial completo | Experimentación con una variante Base y Multi-Query Attention |
| 6.7B | Disponible | Disponible | Completion, chat técnico y pruebas locales moderadas |
| 33B | Disponible | Disponible | Mayor capacidad dentro de la primera generación |
Los checkpoints siguen publicados en la colección oficial de DeepSeek Coder en Hugging Face. Antes de descargar uno, comprueba el nombre completo, el tipo de modelo, la licencia y si estás utilizando el archivo oficial o una cuantización creada por un tercero.
Versiones de DeepSeek-Coder-V2
El repositorio oficial de DeepSeek-Coder-V2 publica cuatro checkpoints principales:
| Checkpoint | Parámetros totales | Parámetros activos | Contexto publicado | Uso principal |
|---|---|---|---|---|
| DeepSeek-Coder-V2-Lite-Base | 16B | 2.4B | 128K | Completion, FIM, experimentación y ajustes |
| DeepSeek-Coder-V2-Lite-Instruct | 16B | 2.4B | 128K | Chat, explicación, generación y depuración |
| DeepSeek-Coder-V2-Base | 236B | 21B | 128K | Investigación, completion y despliegues de gran capacidad |
| DeepSeek-Coder-V2-Instruct | 236B | 21B | 128K | Instrucciones complejas, generación, revisión y razonamiento |
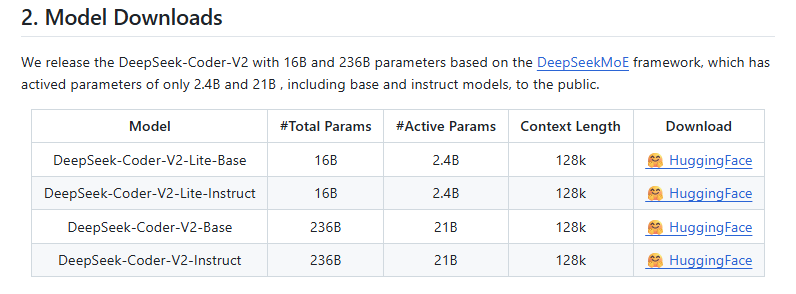
La versión Lite es más accesible que el modelo completo, pero no debe confundirse con un modelo denso pequeño. Sigue necesitando almacenar los 16B parámetros totales, además de memoria para el runtime, la caché, el contexto y el sistema operativo.
La versión completa de 236B no es una instalación práctica para la mayoría de las computadoras personales. Puede requerir varias GPU, distribución del modelo o infraestructura especializada, según la precisión de los pesos, el contexto y el motor de inferencia.
Diferencia entre Base e Instruct
| Necesidad | Base | Instruct |
|---|---|---|
| Autocompletado continuo | Normalmente más apropiado | Puede funcionar, pero está orientado a instrucciones |
| Fill in the Middle local | Diseñado para este tipo de tarea | No suele ser la primera elección |
| Conversación sobre un error | Requiere preparar correctamente el prompt | Más adecuado |
| Generar una función a partir de requisitos | Posible, pero menos cómodo | Más adecuado |
| Explicar o documentar código | No es su uso principal | Más adecuado |
| Fine-tuning o investigación | Ofrece una base más limpia | Ya contiene ajuste para seguir instrucciones |
Base no significa automáticamente “mejor para cualquier autocompletado”. El resultado depende también de la plantilla, el tokenizer, la integración con el editor y la forma en que se construyen el prefijo y el sufijo.
¿Sigue existiendo deepseek-coder en la API?
deepseek-coder fue un identificador de la API durante las primeras etapas del servicio. El 24 de julio de 2024 se actualizó para servir DeepSeek-Coder-V2-0724. El 5 de septiembre de 2024, DeepSeek combinó las capacidades generales y de programación en DeepSeek-V2.5 y mantuvo temporalmente los nombres anteriores por compatibilidad.
Ese identificador histórico no aparece en la lista vigente de modelos de la API. Actualmente se publican:
deepseek-flash, que sirve DeepSeek-V4.1-Flash-1017.deepseek-v4-pro, que sirve la versión alojada de DeepSeek V4 Pro.
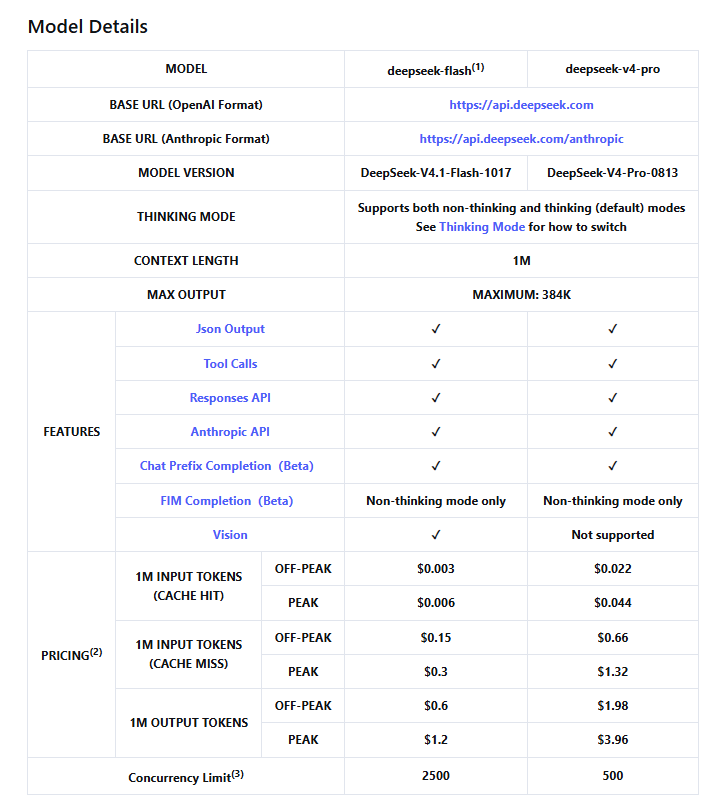
El registro de cambios indica que la web y la aplicación oficiales también se actualizaron a DeepSeek-V4.1-Flash-1017 el 17 de octubre de 2026. Por tanto, utilizar actualmente el chat de DeepSeek para programar no equivale a utilizar el checkpoint DeepSeek Coder original o Coder-V2.
Cómo usar la API actual de DeepSeek para programar
Para una integración nueva, utiliza uno de los identificadores vigentes. Este ejemplo envía una solicitud de revisión de código a deepseek-flash mediante el SDK compatible con OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

code = """
def divide_total(total, users):
    return total / users
"""

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {
            "role": "system",
            "content": (
                "Actúa como revisor de código. Responde en español "
                "latinoamericano neutral y conserva los identificadores."
            ),
        },
        {
            "role": "user",
            "content": (
                "Revisa esta función de Python 3.12. Identifica errores, "
                "propón el cambio mínimo y crea pruebas para cero usuarios, "
                "valores negativos y números decimales.\n\n" + code
            ),
        },
    ],
)

print(response.choices[0].message.content)
El código llama al modelo actual de la API, no a DeepSeek-Coder-V2. Revisa siempre la página oficial de modelos y la respuesta de GET /models antes de fijar un identificador en producción.
Cómo usar FIM Completion para completar código
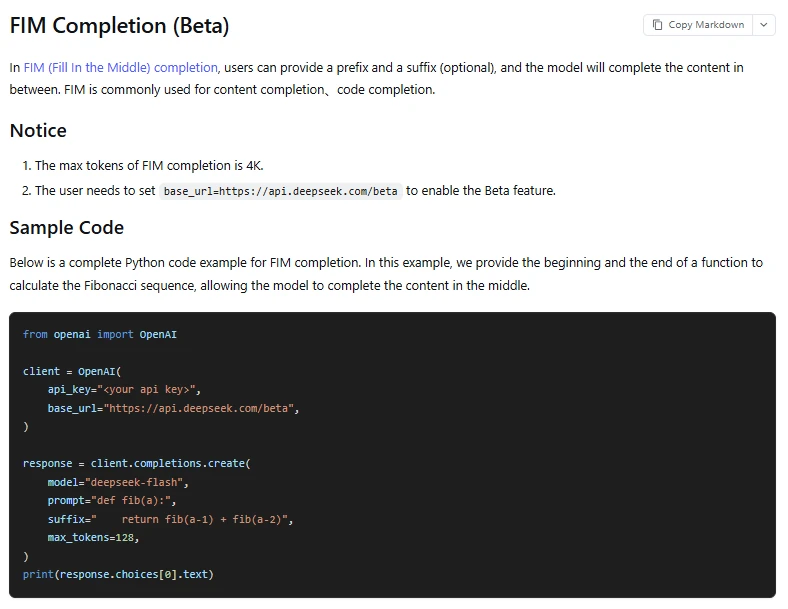
FIM significa Fill in the Middle. En lugar de pedir una función completa, proporcionas el código que aparece antes del hueco y, opcionalmente, el código que aparece después. El modelo genera únicamente la parte intermedia.
La documentación actual de FIM mantiene esta función en beta. Requiere la URL base https://api.deepseek.com/beta, utiliza el endpoint de completions y admite un máximo de 4K tokens de salida. En los modelos actuales, FIM funciona en modo sin razonamiento.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com/beta",
)

response = client.completions.create(
    model="deepseek-flash",
    prompt=(
        "def normalize_name(value: str) -> str:\n"
        "    if not isinstance(value, str):\n"
        "        raise TypeError('value must be a string')\n"
    ),
    suffix=(
        "\n\nassert normalize_name('  Ana   López ') "
        "== 'Ana López'"
    ),
    max_tokens=160,
)

print(response.choices[0].text)
El prefijo contiene el inicio de la función y el sufijo contiene el código que debe permanecer después del hueco. No mezcles este formato de API con los tokens especiales utilizados por algunos checkpoints locales.
Cómo ejecutar DeepSeek-Coder-V2 localmente con Ollama
Ollama publica conversiones de DeepSeek Coder y DeepSeek-Coder-V2. No son los archivos originales de Hugging Face, sino paquetes preparados para el runtime de Ollama.
Para ejecutar la variante de 16B de Coder-V2:
ollama run deepseek-coder-v2:16bLa página actual de DeepSeek-Coder-V2 en Ollama indica una descarga aproximada de 8.9 GB para la etiqueta de 16B y 133 GB para la de 236B. Esos números describen el archivo descargado, no la memoria total que necesitarás durante la inferencia.
Después de iniciar el modelo, utiliza una tarea con resultado verificable:
Escribe una función para Python 3.12 que reciba una lista de enteros y devuelva el segundo valor único más alto. Define qué debe ocurrir si hay menos de dos valores únicos. Incluye pruebas con duplicados, números negativos, lista vacía y un solo valor. No uses paquetes externos.
No evalúes el modelo únicamente por la apariencia de la respuesta. Copia la solución a un proyecto aislado, ejecuta las pruebas y añade casos que la respuesta no haya considerado.
Cómo elegir entre 16B y 236B
| Versión | Ventaja | Limitación principal |
|---|---|---|
| Coder-V2-Lite 16B | Más accesible para pruebas locales y conversación | Menor capacidad que el modelo completo en tareas complejas |
| Coder-V2 236B | Mayor capacidad histórica dentro de la familia V2 | Requiere infraestructura considerable incluso cuantizado |
No existe una cantidad universal de RAM o VRAM. El consumo depende de la cuantización, el runtime, la longitud de contexto, la caché KV, el reparto entre CPU y GPU y otros procesos del sistema. Comprueba el consumo real antes de utilizar el modelo con un repositorio grande.
DeepSeek Coder frente a un coding assistant o un agente
| Componente | Qué hace | Qué no hace por sí solo |
|---|---|---|
| Modelo | Genera texto o código | No accede automáticamente a tus archivos ni ejecuta comandos |
| Autocompletado | Sugiere código dentro del editor | No comprende necesariamente todo el repositorio |
| Chat de editor | Responde preguntas utilizando el contexto compartido | No modifica archivos salvo que la herramienta lo permita |
| Coding assistant | Ayuda a generar, explicar y revisar código | No siempre actúa de forma autónoma |
| Coding agent | Puede explorar archivos, aplicar cambios y ejecutar herramientas | No garantiza que los cambios sean correctos o seguros |
| Harness | Proporciona herramientas, permisos, plugins y ciclo de ejecución | No es el modelo que genera las decisiones |
Cuando conectas DeepSeek a Codex, Claude Code u OpenCode, utilizas un agente externo con los modelos actuales de DeepSeek como backend. No conviertes esa herramienta en DeepSeek Coder original.
Integraciones actuales para trabajar con repositorios
Codex
DeepSeek publica una guía oficial para configurar sus modelos como proveedor de Codex. Codex CLI, la aplicación de escritorio y su extensión para VS Code comparten la misma configuración.
La integración utiliza deepseek-flash o deepseek-v4-pro mediante Responses API. Antes de ejecutar un script de configuración remota, revisa su contenido y conserva la copia de seguridad de tu configuración.
Claude Code
La integración oficial con Claude Code utiliza el endpoint compatible con Anthropic de DeepSeek. Claude Code sigue siendo la herramienta que explora el proyecto y ejecuta acciones; DeepSeek aporta el modelo de fondo.
OpenCode
La guía oficial de OpenCode permite seleccionar DeepSeek como proveedor, introducir una clave de API y elegir el modelo disponible. Esta ruta resulta útil cuando quieres trabajar desde terminal o web sin configurar manualmente cada llamada.
En las tres opciones debes comprobar qué archivos puede leer la herramienta, si puede ejecutar comandos, cuándo solicita confirmación y dónde almacena la clave. Revoca las credenciales si dejas de utilizar la integración.
Qué es DeepSeek Harness y qué riesgos tiene
DeepSeek Harness es una plataforma abierta para construir y ejecutar agentes con plugins. No es un nuevo DeepSeek Coder ni un simple chatbot.
El proyecto se encuentra en developer preview y su aviso oficial indica que no ha pasado una auditoría de seguridad. Puede ejecutar código y comandos generados por el modelo, cargar plugins, acceder a la red, interactuar con procesos y utilizar los archivos o credenciales disponibles en su entorno.
- Utilízalo con los privilegios mínimos necesarios.
- Prefiere una máquina virtual, contenedor o entorno desechable.
- Crea copias de seguridad de los archivos accesibles.
- No expongas credenciales o información sensible.
- Revisa los plugins, la configuración y cada comando propuesto.
- No confíes en el sandbox como único control de seguridad.
No lo utilices directamente sobre un servidor de producción ni sobre la única copia de un repositorio importante sin una evaluación independiente de riesgos.
Prompts útiles para programar con DeepSeek
Un prompt técnico útil debe incluir lenguaje, versión, framework, comportamiento esperado, restricciones, código disponible y pruebas. Evita pedir solamente “corrige este código”.
Diagnosticar un error sin modificar todavía el código
Analiza este error en [lenguaje y versión] con [framework y versión]. Código relevante: [código]. Mensaje exacto: [error]. No propongas cambios todavía. Identifica las tres causas más probables, qué evidencia respalda cada una y qué comprobación mínima puedo ejecutar para confirmarla. No inventes paquetes, archivos ni configuración ausente.
Proponer una corrección mínima
Corrige el siguiente problema con el cambio mínimo posible. Entorno: [lenguaje, versión y framework]. Comportamiento actual: [resultado]. Comportamiento esperado: [resultado]. Conserva las interfaces públicas y no añadas dependencias. Devuelve primero la explicación, después un diff unificado y finalmente las pruebas que demuestran el error y la corrección.
Crear pruebas antes de cambiar la implementación
Crea pruebas para reproducir este error antes de modificar la implementación. Utiliza [framework de pruebas y versión]. Incluye el caso normal, el caso que falla y al menos dos casos límite. No cambies el código de producción. Explica qué debería fallar antes de la corrección y qué debería pasar después.
Refactorizar sin cambiar el comportamiento
Refactoriza este código para mejorar [claridad, duplicación o mantenibilidad] sin cambiar su comportamiento observable. Conserva firmas, tipos de retorno, excepciones y efectos secundarios. Enumera los riesgos antes de editar, devuelve un diff y añade pruebas de regresión. No actualices dependencias ni utilices APIs que no aparezcan en la versión instalada.
Revisar un pull request
Revisa este diff como si fuera un pull request. Busca errores funcionales, condiciones de carrera, problemas de seguridad, pérdida de compatibilidad, cambios de contrato y pruebas ausentes. Para cada hallazgo, cita el archivo y la línea afectada, explica un escenario reproducible y clasifica el impacto. No marques preferencias de estilo como errores funcionales.
Diseñar una migración segura
Diseña una migración de [versión actual] a [versión objetivo]. Utiliza únicamente la documentación proporcionada: [enlaces o fragmentos]. Separa cambios obligatorios, cambios opcionales, incompatibilidades y estrategia de reversión. Propón un entorno de prueba y una checklist de validación. No inventes flags, métodos ni paquetes.
Cómo verificar el código generado
Un modelo puede producir una solución que parece profesional y no compila, utiliza una API retirada o falla con una entrada inesperada. La revisión debe formar parte del flujo, no ser una tarea opcional.
- Comprende el cambio. No ejecutes código que no puedas explicar a un nivel suficiente para evaluar su efecto.
- Revisa el diff. Comprueba cada archivo modificado y busca cambios no solicitados.
- Verifica dependencias y APIs. Abre la documentación oficial y confirma versiones, firmas y parámetros.
- Ejecuta el linter y el comprobador de tipos. Utiliza las herramientas definidas por el proyecto.
- Ejecuta las pruebas existentes. Una corrección no debe romper comportamientos que ya funcionaban.
- Añade una prueba de regresión. Reproduce el problema original antes de aceptar la solución.
- Prueba casos límite. Incluye valores vacíos, límites numéricos, errores de red, concurrencia o permisos cuando correspondan.
- Revisa logs y excepciones. Comprueba que no se oculten fallos ni se filtren datos sensibles.
- Ejecuta análisis de seguridad. Escanea secretos, dependencias y patrones peligrosos cuando la naturaleza del proyecto lo requiera.
- Realiza una revisión humana. No fusiones automáticamente un cambio importante solo porque las pruebas pasaron.
Que el código compile tampoco demuestra que sea seguro, eficiente o compatible con todos los requisitos. Las pruebas solo verifican los escenarios que realmente ejecutaste.
Cómo detectar paquetes y APIs inventados
DeepSeek Coder y otros modelos pueden mezclar documentación de versiones diferentes o proponer dependencias que no existen. Antes de instalar algo generado por IA:
- Busca el paquete en el registro oficial del ecosistema.
- Comprueba que el propietario y el repositorio sean legítimos.
- Revisa la fecha de la última versión y su mantenimiento.
- Confirma la licencia.
- Abre la documentación de la versión instalada.
- Comprueba la firma real de clases, métodos y parámetros.
- Revisa el changelog para detectar funciones retiradas.
- Consulta vulnerabilidades conocidas antes de añadir la dependencia.
No instales un paquete desconocido únicamente porque el nombre parezca adecuado. Los ataques de dependencia pueden aprovechar nombres similares o errores de escritura.
Benchmarks de Coder-V2: qué significan y qué no
DeepSeek publicó resultados históricos para los modelos Coder-V2 en 2024. Estos datos permiten comparar Lite y la versión completa bajo aquella metodología, pero no demuestran cuál es el mejor modelo de programación disponible en 2026.
| Modelo | HumanEval | MBPP+ | LiveCodeBench | USACO |
|---|---|---|---|---|
| Coder-V2-Lite-Instruct | 81.1 | 68.8 | 24.3 | 6.5 |
| Coder-V2-Instruct | 90.2 | 76.2 | 43.4 | 12.1 |
Los resultados dependen del modelo, conjunto de problemas, configuración y métrica. Un benchmark de generación corta no representa automáticamente la capacidad para modificar un repositorio, corregir una aplicación real o seguir las convenciones internas de un equipo.
La prueba más útil es un conjunto de tareas propias con criterios definidos: compilación, cobertura, pruebas de regresión, calidad del diff, consumo de recursos y número de intervenciones humanas necesarias.
¿DeepSeek Coder funciona con instrucciones en español?
Las fuentes oficiales describen principalmente entrenamiento de lenguaje natural en inglés y chino, y no publican una tasa independiente de precisión para prompts en español. Por eso, no debe asignarse un porcentaje de rendimiento en español sin una evaluación específica.
Puedes escribir la explicación y los requisitos en español, pero conserva literalmente:
- Nombres de funciones y variables.
- Comandos de terminal.
- Rutas de archivos.
- Nombres de paquetes y APIs.
- Mensajes exactos de error.
- Versiones y nombres de configuración.
Responde en español latinoamericano neutral. Mantén sin traducir identificadores, comandos, rutas, nombres de paquetes y mensajes de error. Separa diagnóstico, cambio propuesto, diff, pruebas y riesgos. Si falta información del entorno, solicítala antes de inventar una solución.
Licencia y uso comercial
Los repositorios de código de DeepSeek Coder y Coder-V2 se publican bajo licencia MIT. Los pesos están sujetos a una licencia de modelo separada, y DeepSeek declara que las familias Coder y Coder-V2 permiten uso comercial.
Esto no significa que todo archivo relacionado con DeepSeek Coder utilice MIT. Una cuantización, conversión, integración o aplicación de terceros puede imponer sus propias condiciones. También debes revisar las licencias de cualquier dependencia o fragmento incluido en el código generado.
El hecho de que un modelo genere código no garantiza que el resultado esté libre de derechos de terceros. Para usos sensibles o comerciales, aplica revisión técnica y jurídica según la naturaleza del proyecto. Esta explicación no constituye asesoría legal.
Privacidad y seguridad del repositorio
La privacidad no depende únicamente del modelo. Debes revisar toda la cadena: editor, plugin, API, proveedor, agente, almacenamiento de logs y herramientas conectadas.
| Ruta | Dónde se procesa el código | Riesgo principal |
|---|---|---|
| Chat o API oficial | Infraestructura de DeepSeek | Enviar código o datos sensibles a un servicio externo |
| Proveedor externo | Infraestructura de ese proveedor | Políticas diferentes de retención, acceso y ubicación |
| Modelo local | Tu computadora o servidor | Telemetría, plugins, logs o herramientas externas |
| Coding agent | Depende del proveedor y la configuración | Acceso amplio a archivos, comandos y credenciales |
| Infraestructura empresarial propia | Entorno controlado por la organización | Permisos mal configurados, registros o accesos internos |
No compartas claves API, contraseñas, archivos de entorno, certificados, datos de clientes, secretos comerciales ni código privado no autorizado. Usa datos ficticios o fragmentos anonimizados cuando el contexto completo no sea necesario.
Antes de permitir que un agente ejecute comandos, confirma que el repositorio tenga una copia de seguridad o commits recuperables, utiliza una rama separada y evita conceder acceso administrativo.
Checklist antes de aceptar código generado
- ¿Comprendes qué modifica cada línea?
- ¿El modelo utilizó el lenguaje, framework y versiones correctos?
- ¿Las dependencias existen y proceden de una fuente legítima?
- ¿El cambio conserva los contratos e interfaces públicas?
- ¿El diff contiene archivos o cambios no solicitados?
- ¿El código compila y supera el linter?
- ¿Pasan las pruebas existentes?
- ¿Existe una prueba que reproduzca el problema original?
- ¿Se probaron entradas vacías, límites y errores?
- ¿Se revisaron autenticación, autorización y exposición de datos?
- ¿Los logs podrían revelar información sensible?
- ¿Existe una estrategia para revertir el cambio?
- ¿Una persona con conocimiento del proyecto revisó la versión final?
Preguntas frecuentes
¿DeepSeek Coder sigue disponible?
Sí. Los checkpoints originales y DeepSeek-Coder-V2 siguen publicados en los repositorios oficiales y en Hugging Face. Sin embargo, deepseek-coder ya no figura como identificador vigente de la API oficial.
¿Qué modelo actual de DeepSeek conviene para programar?
Para la API alojada, utiliza uno de los IDs vigentes: deepseek-flash o deepseek-v4-pro. Para ejecutar específicamente la familia Coder, elige un checkpoint local según tu objetivo y hardware.
¿Cuál es la diferencia entre Base e Instruct?
Base está orientado a completion, FIM, investigación y ajustes. Instruct está afinado para seguir peticiones, conversar, explicar y depurar. La plantilla utilizada por el runtime también influye en el resultado.
¿Qué significa Coder-V2-Lite?
Es la variante de 16B parámetros totales y 2.4B activos de la arquitectura MoE. Es más accesible que la versión de 236B, pero no equivale a un modelo denso de 2.4B.
¿DeepSeek Coder puede ejecutar código?
El modelo solo genera texto. La ejecución corresponde al runtime, editor, agente o harness conectado. Conceder esa capacidad aumenta el riesgo y requiere permisos mínimos y revisión de comandos.
¿Puede revisar un repositorio completo?
Puede revisar los archivos que una herramienta seleccione y comparta dentro del contexto disponible. Una ventana amplia no garantiza que comprenda automáticamente todo el repositorio, sus dependencias, historial y convenciones internas.
¿Cuánta RAM o VRAM necesita?
No existe una cifra universal. Depende del checkpoint, la cuantización, el contexto, el runtime, la caché y la distribución entre CPU y GPU. El tamaño de descarga no representa toda la memoria de ejecución.
¿Puede usarse con VS Code?
Sí, mediante herramientas que admitan DeepSeek como proveedor o una API compatible. La extensión es un producto separado del modelo, por lo que debes revisar qué modelo utiliza, qué datos envía y qué permisos solicita.
¿DeepSeek Coder es mejor que GitHub Copilot?
No es una comparación directa. DeepSeek Coder es una familia de modelos, mientras que GitHub Copilot es un servicio integrado con editores y flujos de desarrollo. Una comparación útil debe fijar modelo, herramienta, precio, latencia, privacidad y tareas reales.
¿Se puede utilizar comercialmente?
DeepSeek declara soporte para uso comercial en las familias Coder y Coder-V2, sujeto a sus licencias de modelo. Revisa además la licencia del runtime, la conversión y las dependencias utilizadas.
Fuentes oficiales consultadas
- Repositorio oficial de DeepSeek Coder.
- Repositorio oficial de DeepSeek-Coder-V2.
- Modelo oficial Coder-V2-Lite-Instruct.
- Registro oficial de cambios de DeepSeek.
- Lista oficial de modelos de la API.
- Documentación oficial de FIM Completion.
- Integración oficial con Codex.
- Integración oficial con Claude Code.
- Integración oficial con OpenCode.
- Repositorio oficial de DeepSeek Harness.
- Aviso de seguridad de DeepSeek Harness.
- DeepSeek-Coder-V2 en Ollama.