
DeepSeek R1 es una familia de modelos de razonamiento presentada por DeepSeek el 20 de enero de 2025. Sus pesos continúan disponibles para descarga, investigación y ejecución propia, pero R1 ya no es el modelo que atiende por defecto las conversaciones del servicio oficial de DeepSeek.
A fecha del 10 de noviembre de 2026, la web y la aplicación oficiales utilizan una generación posterior, DeepSeek-V4.1-Flash-1017. La API tampoco ofrece actualmente un modelo llamado deepseek-reasoner: sus identificadores vigentes son deepseek-flash y deepseek-v4-pro, ambos con un modo de pensamiento configurable.
Por eso, buscar “DeepSeek R1” puede significar dos cosas diferentes: utilizar el razonamiento actual de DeepSeek o ejecutar específicamente los pesos de R1, R1-0528 o alguno de sus modelos Distill. Esta guía separa ambos caminos para que elijas el que realmente necesitas.
Modelos, repositorios, API y documentación verificados el 10 de noviembre de 2026.
Qué debes usar según tu objetivo
| Tu objetivo | Ruta recomendada | Qué modelo utilizarás |
|---|---|---|
| Usar el mejor razonamiento actual de DeepSeek sin instalar nada | Web o aplicación oficial | El modelo vigente del servicio, no necesariamente R1 |
| Integrar el razonamiento actual mediante API | deepseek-flash o deepseek-v4-pro con Thinking Mode | DeepSeek V4.1 Flash o V4 Pro |
| Estudiar o probar el R1 original | Pesos oficiales en Hugging Face | DeepSeek-R1 |
| Utilizar la revisión más reciente de la familia R1 | Checkpoint oficial R1-0528 | DeepSeek-R1-0528 |
| Ejecutar un modelo R1 en una computadora personal | Ollama, LM Studio u otro motor local | Normalmente una variante Distill o Qwen3-8B |
| Ejecutar el modelo completo | Infraestructura especializada | R1 o R1-0528 de 671B parámetros |
Si solo quieres hacer preguntas complejas, programar o resolver problemas mediante la web, no necesitas descargar R1. La descarga tiene sentido cuando necesitas estudiar ese checkpoint concreto, controlar la inferencia, trabajar sin conexión o desplegar un modelo en tu propia infraestructura.
Qué es DeepSeek R1
DeepSeek R1 es un modelo orientado a tareas que requieren varios pasos de razonamiento, como matemáticas, programación, lógica, planificación y análisis de problemas. Antes de producir la respuesta final, genera una secuencia interna de procesamiento más extensa que la de un modelo de respuesta inmediata.
Esto no significa que razone como una persona ni que una explicación larga garantice una respuesta correcta. El modelo puede seguir un procedimiento coherente y aun así partir de un supuesto falso, cometer un error de cálculo o inventar información.
El repositorio oficial de DeepSeek R1 publica para R1 y R1-Zero estas especificaciones:
| Especificación | DeepSeek-R1 |
|---|---|
| Arquitectura | Mixture of Experts, abreviado MoE |
| Parámetros totales | 671 mil millones |
| Parámetros activados | 37 mil millones por token |
| Contexto publicado | 128K tokens |
| Modelo base | DeepSeek-V3-Base |
| Tipo de entrada | Texto |
| Licencia principal | MIT |
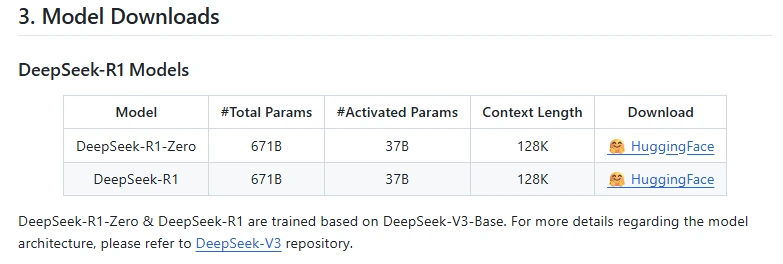
Una arquitectura MoE contiene numerosos grupos de parámetros, pero solo activa una parte de ellos para procesar cada token. Los 37B activados ayudan a explicar el costo de cómputo durante la inferencia, pero no significan que el archivo completo ocupe lo mismo que un modelo denso de 37B.
También debes separar la longitud de contexto teórica de la que realmente puedes utilizar. Mantener un contexto grande aumenta el consumo de memoria, de modo que una instalación local puede necesitar un límite mucho menor aunque el checkpoint admita 128K.
R1 no es el modelo actual de la web ni de la API
En enero de 2025, el anuncio oficial permitía acceder a R1 desde la web mediante DeepThink y desde la API con el identificador deepseek-reasoner. Esas instrucciones describían correctamente el servicio de aquel momento, pero no la oferta actual.
DeepSeek anunció el 24 de abril de 2026 que deepseek-chat y deepseek-reasoner dejarían de utilizarse el 24 de julio de 2026. Durante la transición, ambos nombres apuntaban a modos de DeepSeek-V4-Flash.
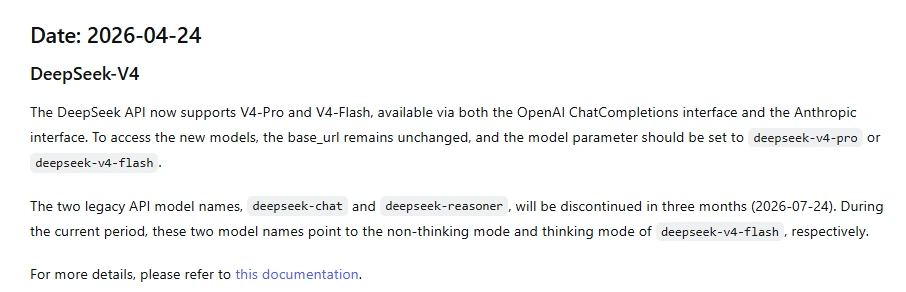
La lista oficial de modelos de la API muestra actualmente:
deepseek-flash, que corresponde a DeepSeek-V4.1-Flash-1017.deepseek-v4-pro, que corresponde a la versión alojada de DeepSeek V4 Pro.
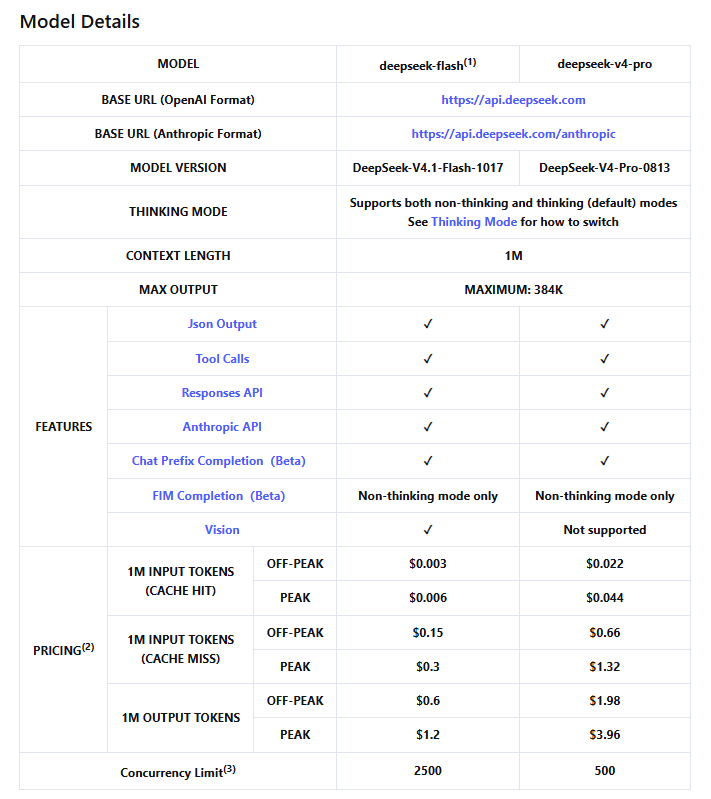
Por tanto, un código que todavía utiliza deepseek-reasoner debe actualizarse. Tampoco debes asumir que un botón denominado DeepThink identifica a R1: ese nombre se ha utilizado para activar razonamiento en generaciones posteriores.
Línea de tiempo de DeepSeek R1 y los modelos posteriores
| Fecha | Cambio | Qué significa hoy |
|---|---|---|
| 20 de enero de 2025 | Presentación de DeepSeek-R1, R1-Zero y seis modelos Distill | Inicio de la familia R1 y del antiguo ID deepseek-reasoner |
| 28 de mayo de 2025 | Publicación de DeepSeek-R1-0528 | Revisión mejorada de R1, todavía disponible como pesos abiertos |
| 24 de abril de 2026 | DeepSeek anuncia V4 y la retirada de los IDs anteriores | deepseek-reasoner deja de representar un producto permanente |
| 24 de julio de 2026 | Fecha anunciada para retirar deepseek-chat y deepseek-reasoner | Los proyectos deben utilizar los identificadores actuales |
| 10 de septiembre de 2026 | Lanzamiento de DeepSeek-V4.1-Flash | La API pasa a utilizar deepseek-flash |
| 17 de octubre de 2026 | Actualización a V4.1-Flash-1017 | La web y la aplicación oficiales se actualizan a esa revisión |
Los pesos de R1 no desaparecieron cuando el servicio alojado cambió. Lo que cambió fue el modelo que DeepSeek opera en sus propios servidores. Puedes seguir descargando R1, pero abrir el chat oficial no equivale actualmente a ejecutar ese checkpoint.
R1-Zero, R1, R1-0528 y R1-Distill: diferencias
| Nombre | Qué es | Para quién tiene sentido |
|---|---|---|
| DeepSeek-R1-Zero | Modelo experimental entrenado con aprendizaje por refuerzo sin una fase SFT previa | Investigadores interesados en el surgimiento de capacidades de razonamiento mediante RL |
| DeepSeek-R1 | Modelo de 671B que añade datos de arranque en frío y un proceso de entrenamiento por etapas | Investigación, evaluación y despliegue con infraestructura de gran capacidad |
| DeepSeek-R1-0528 | Actualización de R1 publicada el 28 de mayo de 2025 | Quien quiera la revisión más capaz dentro de la familia R1 completa |
| DeepSeek-R1-Distill | Modelos Qwen y Llama ajustados con datos generados por R1 | Usuarios que necesitan una opción más pequeña para inferencia local |
| DeepSeek-R1-0528-Qwen3-8B | Modelo Qwen3 de 8B postentrenado con datos de razonamiento de R1-0528 | Pruebas locales más accesibles con la revisión de mayo de 2025 |
DeepSeek-R1-Zero
R1-Zero buscaba comprobar si un modelo base podía desarrollar comportamientos de razonamiento mediante aprendizaje por refuerzo a gran escala, sin comenzar con una etapa tradicional de ajuste supervisado.
DeepSeek documentó comportamientos como verificación y reflexión, pero también problemas de repetición interminable, legibilidad deficiente y mezcla de idiomas. R1-Zero es importante como experimento, aunque no suele ser la opción más práctica para un usuario final.
DeepSeek-R1
R1 incorpora datos de arranque en frío antes de la fase principal de aprendizaje por refuerzo. Su proceso incluye etapas de ajuste supervisado y RL para mejorar tanto el razonamiento como la presentación de las respuestas.
Este es el modelo de 671B al que normalmente se refiere el nombre “DeepSeek R1 original”. No debe confundirse con las variantes de 7B, 8B o 32B, que son modelos destilados separados.
DeepSeek-R1-0528
DeepSeek-R1-0528 es una actualización menor de la familia completa, no una arquitectura totalmente independiente. DeepSeek declara mejoras en profundidad de razonamiento, programación, llamadas a funciones y reducción de alucinaciones.
El nombre 0528 corresponde a la fecha de publicación, 28 de mayo. Aunque sus pesos siguen disponibles, DeepSeek-R1-0528 no es un identificador válido de la API alojada actual.
Modelos R1-Distill
La destilación utiliza respuestas o patrones generados por un modelo grande para entrenar otro modelo más pequeño. Un modelo Distill no contiene el modelo completo reducido sin cambios: tiene su propia arquitectura, tokenizer, comportamiento y requisitos.
| Modelo oficial | Modelo base | Tamaño |
|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 1.5B |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 7B |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 8B |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 14B |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 32B |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70B |
DeepSeek publicó además DeepSeek-R1-0528-Qwen3-8B, derivado de Qwen3-8B y postentrenado con datos de razonamiento de R1-0528. Es una variante posterior y no forma parte de los seis Distill originales de enero de 2025.
Para qué sirve DeepSeek R1
R1 fue diseñado para tareas en las que una respuesta rápida no basta y es necesario combinar varios pasos. Sus usos más razonables incluyen:
- Resolver y revisar problemas matemáticos.
- Explicar algoritmos y analizar su complejidad.
- Detectar errores en código y proponer pruebas.
- Comparar estrategias para resolver un problema.
- Descomponer una tarea compleja en etapas.
- Revisar supuestos, restricciones y casos límite.
- Investigar el comportamiento de modelos de razonamiento.
No todas las preguntas necesitan R1. Para resumir un párrafo, traducir una frase o redactar un correo breve, un modelo más rápido puede ser suficiente. El razonamiento extenso puede aumentar la latencia y generar respuestas innecesariamente largas.
¿DeepSeek R1 funciona en español?
R1 y sus variantes pueden recibir instrucciones y generar respuestas en español. Sin embargo, las tablas principales de evaluación publicadas por DeepSeek se concentran en inglés, chino, matemáticas y programación; no ofrecen una cifra oficial independiente que demuestre un porcentaje concreto de precisión en español.
Una respuesta fluida tampoco demuestra que los conceptos, términos técnicos o referencias sean correctos. Para trabajar en español latinoamericano, incluye una instrucción explícita como esta:
Responde en español latinoamericano neutral. Utiliza “tú”, “computadora” y “celular”. Separa los supuestos, el procedimiento verificable y la respuesta final. Si falta información, indícalo en lugar de inventarla.
Cuando el tema utilice terminología especializada, proporciona un glosario o las fuentes que deseas seguir. Después, comprueba nombres, fórmulas, cifras y traducciones con documentación independiente.
Cómo usar el razonamiento actual desde DeepSeek Web o la app
Esta ruta es la más sencilla si no necesitas ejecutar específicamente los pesos de R1.
- Entra en DeepSeek Web o instala la aplicación desde la página oficial de descarga.
- Abre una conversación nueva para evitar que instrucciones anteriores modifiquen la tarea.
- Activa la opción de razonamiento o pensamiento que muestre tu versión de la interfaz cuando la tarea lo requiera.
- Especifica el problema, los datos disponibles, las restricciones y el formato de la respuesta final.
- Pide una comprobación separada de cálculos, supuestos o casos límite.
- Verifica el resultado con una fuente, una prueba o un método independiente.
Este procedimiento utiliza el modelo alojado actual. Aunque la interfaz muestre un control llamado DeepThink o Thinking, eso no demuestra que el servidor esté ejecutando R1.
Cómo utilizar el modo de pensamiento de la API actual
La API vigente permite activar o desactivar el modo de pensamiento y controlar su esfuerzo mediante los niveles low, high y max. El valor predeterminado es high.
El siguiente ejemplo utiliza deepseek-flash. Es importante entender que llama a DeepSeek-V4.1-Flash-1017, no a DeepSeek R1:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {
            "role": "system",
            "content": "Responde en español latinoamericano neutral."
        },
        {
            "role": "user",
            "content": (
                "Compara dos métodos para resolver este problema. "
                "Indica supuestos, casos límite y una comprobación final."
            ),
        },
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {
            "type": "enabled"
        }
    },
)

print(response.choices[0].message.content)
En el modo de pensamiento actual, parámetros como temperature, presence_penalty y frequency_penalty no tienen efecto. Utiliza reasoning_effort para ajustar el esfuerzo en lugar de aplicar automáticamente la configuración histórica de R1.
Cómo ejecutar DeepSeek R1 localmente con Ollama
Ollama ofrece una forma sencilla de descargar y ejecutar conversiones de R1 en Windows, macOS y Linux. El proceso se realiza en tu computadora después de descargar el modelo, aunque debes comprobar que ninguna herramienta, extensión o interfaz adicional envíe datos a servicios externos.
Instala Ollama desde su sitio oficial y abre PowerShell o Terminal. Para descargar explícitamente la variante actual de 8B, ejecuta:
ollama pull deepseek-r1:8b
ollama ls
Después, inicia la conversación:
ollama run deepseek-r1:8bCuando aparezca el campo de entrada, prueba una petición verificable:
Responde en español. Ordena 17, 4 y 12 de menor a mayor, calcula la suma y comprueba el resultado con una segunda operación.
La referencia correcta es 4, 12 y 17, con una suma de 33. Una prueba con resultado conocido permite comprobar el comportamiento básico mejor que una pregunta cuya respuesta no puedes evaluar.
Para salir, escribe /bye. Mientras el modelo esté cargado, puedes abrir otra terminal y ejecutar:
ollama psEste comando permite revisar qué modelo está activo, el procesador utilizado y el contexto configurado. La afirmación del propio chatbot de que funciona localmente no es una prueba técnica.
Qué modelo descarga Ollama actualmente
El catálogo actual de Ollama utiliza deepseek-r1 y deepseek-r1:8b para DeepSeek-R1-0528-Qwen3-8B. Como las etiquetas pueden actualizarse, utiliza siempre un tag explícito y revisa la página de DeepSeek R1 en Ollama antes de automatizar una descarga.
Los tamaños publicados actualmente por Ollama son tamaños aproximados de descarga, no requisitos garantizados de RAM o VRAM:
| Etiqueta de Ollama | Tamaño de descarga aproximado | Tipo general |
|---|---|---|
deepseek-r1:1.5b | 1.1 GB | Distill compacto |
deepseek-r1:7b | 4.7 GB | Distill Qwen |
deepseek-r1:8b | 5.2 GB | R1-0528-Qwen3-8B actual |
deepseek-r1:14b | 9.0 GB | Distill Qwen |
deepseek-r1:32b | 20 GB | Distill Qwen |
deepseek-r1:70b | 43 GB | Distill Llama |
deepseek-r1:671b | 404 GB | Modelo completo cuantizado |
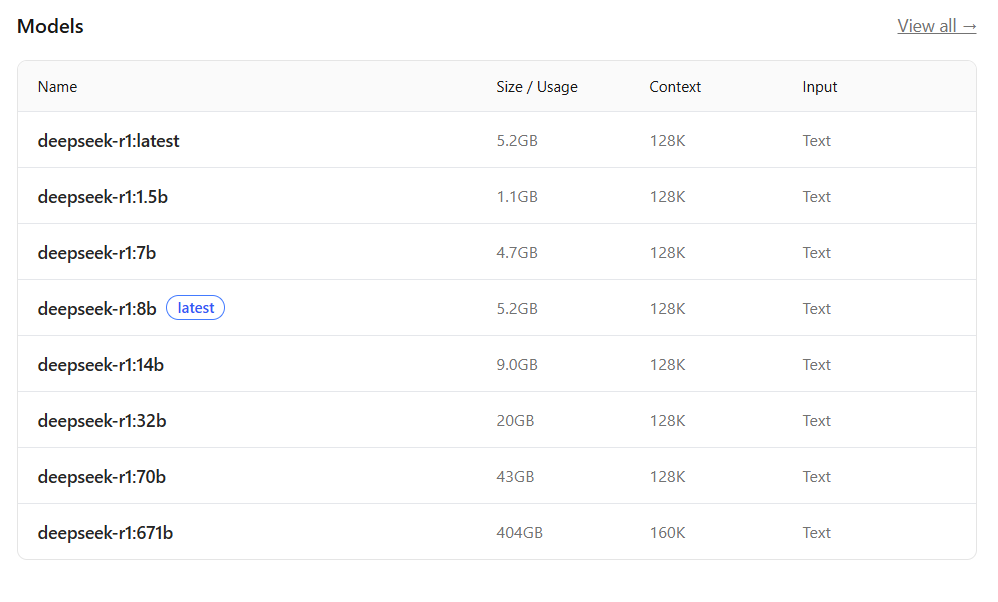
El archivo descargado no es el único consumo. La ejecución necesita memoria para los pesos, el contexto, la caché y el propio motor. Un archivo de 5.2 GB no garantiza que 5.2 GB de RAM sean suficientes.
Cómo elegir una versión para tu computadora
No elijas únicamente por el número de parámetros. Considera la memoria libre, el tipo de procesador, la aceleración disponible, la cuantización, el contexto que utilizarás y la calidad que exige tu tarea.
| Necesidad | Punto de partida razonable | Qué debes aceptar |
|---|---|---|
| Comprobar que la ejecución local funciona | 1.5B | Capacidad y precisión limitadas |
| Probar razonamiento local sin una descarga grande | 7B u 8B | Resultados inferiores al modelo completo en tareas difíciles |
| Mayor capacidad con hardware suficiente | 14B o 32B | Más memoria, almacenamiento y tiempo de generación |
| Tareas exigentes con infraestructura de alto nivel | 70B | Requisitos elevados y menor velocidad en equipos modestos |
| Investigar el modelo completo | 671B | Infraestructura especializada; no es una descarga práctica para la mayoría de computadoras personales |
La cuantización reduce la precisión numérica de los pesos para disminuir el tamaño y el consumo. Una cuantización más agresiva puede facilitar la ejecución, pero también puede afectar la calidad. La destilación y la cuantización no son lo mismo: la primera entrena otro modelo; la segunda representa los pesos existentes con menos precisión.
Empieza con un contexto corto y aumenta solo cuando la tarea lo exija. Cargar el máximo contexto anunciado puede consumir mucha memoria incluso si la pregunta contiene poco texto.
Prompts y configuración según la versión
Las recomendaciones no son idénticas para R1 original, R1-0528 y los modelos actuales de la API.
| Versión | Recomendación documentada | Qué evitar |
|---|---|---|
| R1 original | Temperatura entre 0.5 y 0.7, con 0.6 como referencia; instrucciones dentro del mensaje del usuario | Aplicar un system prompt complejo sin comprobar su efecto |
| R1 original en evaluaciones matemáticas | Pedir procedimiento y una respuesta final claramente delimitada | Evaluar una sola muestra como resultado universal |
| R1-0528 | Admite system prompt | Añadir manualmente <think> para forzar el razonamiento |
| API actual de DeepSeek | Utilizar Thinking Mode y reasoning_effort | Esperar que temperature controle el modo de pensamiento |
| Modelos Distill | Respetar el tokenizer y la plantilla del modelo o del proveedor | Suponer que toda recomendación del R1 completo produce el mismo resultado |
Una plantilla práctica para tareas de razonamiento es:
Analiza el siguiente problema: [problema]. Datos disponibles: [datos]. Restricciones: [restricciones]. Explica brevemente los supuestos y el método verificable, comprueba los casos límite y termina con una respuesta final separada. Si falta información, indícala en lugar de inventarla. Responde en español latinoamericano neutral.
No necesitas solicitar una cadena interna completa de pensamiento. Es más útil pedir supuestos, pasos resumidos, fórmulas, pruebas y una respuesta final que puedas revisar.
Qué muestran los benchmarks de R1-0528
La ficha oficial de R1-0528 compara la revisión de mayo con el R1 anterior. Estos son algunos de los resultados publicados:
| Benchmark | Métrica | R1 anterior | R1-0528 |
|---|---|---|---|
| GPQA Diamond | Pass@1 | 71.5 | 81.0 |
| AIME 2025 | Pass@1 | 70.0 | 87.5 |
| LiveCodeBench | Pass@1 | 63.5 | 73.3 |
| SWE Verified | Problemas resueltos | 49.2 | 57.6 |
| Aider Polyglot | Exactitud | 53.3 | 71.6 |
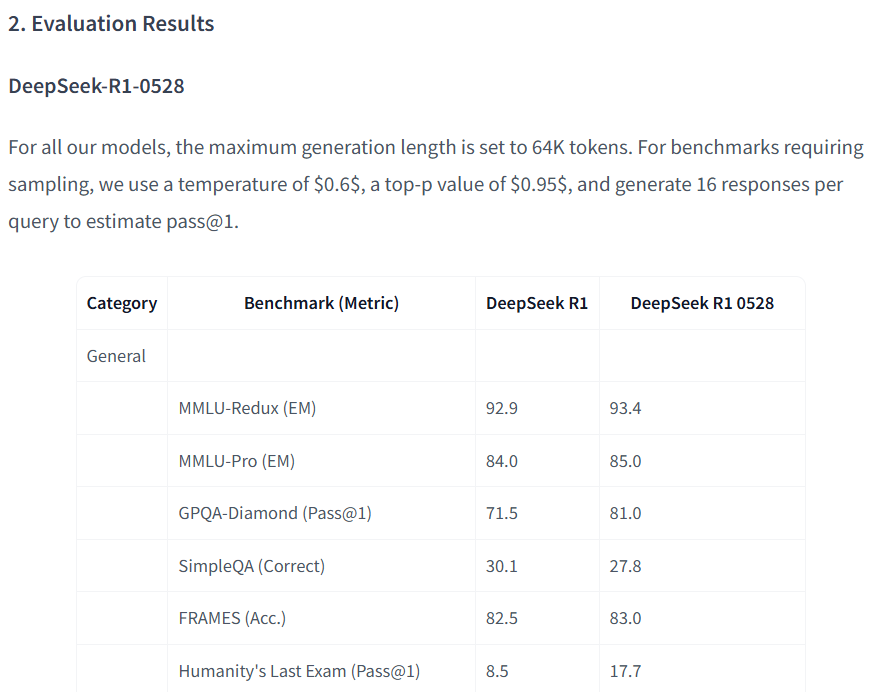
Para las pruebas que requieren muestreo, DeepSeek documentó temperatura 0.6, top_p de 0.95 y 16 respuestas por consulta para estimar Pass@1. La longitud máxima de generación utilizada fue de 64K tokens.
Pass@1 estima la probabilidad de obtener una respuesta correcta en un intento. No significa que el modelo acertará ese porcentaje en cualquier tarea personal.
Estos resultados tampoco deben utilizarse como una comparación actual con todos los modelos de 2026. El anuncio original comparaba R1 con versiones disponibles a comienzos de 2025, como OpenAI o1-1217. La comparación es histórica y depende de la versión, configuración y metodología.
DeepSeek R1 frente a los modelos actuales
| Criterio | DeepSeek R1 | DeepSeek alojado actual |
|---|---|---|
| Generación | Modelo presentado en enero de 2025 | Familia V4.1 y V4 |
| Acceso oficial alojado | No figura como ID actual de API | Web, aplicación y API |
| Pesos descargables | Sí | No necesariamente para cada modelo alojado |
| Uso local | Sí, con pesos propios o conversiones | Depende de que DeepSeek publique el modelo correspondiente |
| Multimodalidad | R1 es un modelo de texto | DeepSeek V4.1 Flash admite texto e imágenes |
| Control de razonamiento en API | Configuración dependiente del checkpoint y motor | low, high y max |
| Mejor opción para una integración nueva | Solo si necesitas específicamente R1 en infraestructura propia | Utilizar los IDs actuales de la API |
No existe un ganador universal. R1 sigue siendo útil para investigación, reproducción de resultados, despliegues propios y comparación histórica. El servicio actual suele ser más práctico cuando quieres capacidades recientes, herramientas, soporte multimodal y una API administrada.
Licencia y uso comercial
El repositorio y los pesos principales de DeepSeek R1 están publicados bajo licencia MIT. DeepSeek indica que la familia permite uso comercial, modificaciones, obras derivadas y destilación.
Sin embargo, debes revisar la procedencia de cada variante:
- Las variantes Distill basadas en Qwen proceden de modelos base publicados originalmente bajo Apache 2.0.
- DeepSeek-R1-Distill-Llama-8B deriva de Llama 3.1 y conserva consideraciones de su licencia base.
- DeepSeek-R1-Distill-Llama-70B deriva de Llama 3.3 y requiere revisar esa licencia.
- Una conversión GGUF, cuantización o paquete de terceros puede incluir condiciones o avisos adicionales.
No asumas que todos los archivos que contienen “DeepSeek R1” en el nombre son oficiales. Comprueba el propietario del repositorio, el modelo base, la licencia y el hash o procedencia del archivo. Esta explicación no sustituye asesoría legal.
Privacidad: servicio alojado, ejecución local y proveedores externos
| Ruta | Dónde se procesa la petición | Qué debes revisar |
|---|---|---|
| Web o aplicación oficial | Infraestructura de DeepSeek | Política de privacidad, historial y controles de datos |
| API oficial | Infraestructura de DeepSeek | Términos de la plataforma, registros y tratamiento de datos |
| Ollama o LM Studio local | Tu computadora, si no se conectan servicios externos | Telemetría, extensiones, herramientas web, registros y permisos |
| Proveedor externo | Servidores de ese proveedor | Su propia política, ubicación, retención y controles |
| Servidor empresarial propio | Infraestructura controlada por la organización | Accesos, cifrado, logs, copias y políticas internas |
La política de privacidad de DeepSeek indica que las entradas del servicio pueden incluir prompts, archivos, fotos e historial de conversaciones, y que los datos pueden utilizarse para operar y mejorar la tecnología.
No introduzcas contraseñas, claves API, código privado, expedientes médicos, documentos confidenciales, información personal identificable ni secretos comerciales sin una evaluación previa y una base autorizada.
Ejecutar un modelo local reduce la necesidad de enviar el prompt al proveedor, pero no garantiza privacidad por sí solo. Una interfaz puede utilizar telemetría, una extensión puede enviar contenido a internet y una herramienta conectada puede disponer de permisos amplios sobre tus archivos.
Errores frecuentes al elegir o usar DeepSeek R1
| Error | Corrección |
|---|---|
| Creer que DeepThink siempre significa R1 | Comprueba qué modelo utiliza actualmente la interfaz o el proveedor |
Usar deepseek-reasoner en una integración nueva | Consulta la lista actual y utiliza deepseek-flash o deepseek-v4-pro |
| Llamar R1 completo a un modelo de 7B u 8B | Identifícalo como Distill o R1-0528-Qwen3-8B |
| Confundir destilación con cuantización | La destilación entrena otro modelo; la cuantización reduce la precisión de los pesos |
| Calcular la RAM solo con el tamaño del archivo | Añade memoria para contexto, caché, motor y sistema operativo |
| Cargar 128K porque el modelo lo admite | Usa el contexto mínimo necesario y observa el consumo real |
| Aplicar el prompting del R1 original a R1-0528 | Revisa las recomendaciones específicas de la versión |
| Tratar un benchmark como garantía | Prueba tareas representativas con tu configuración y datos |
| Confiar en un razonamiento largo | Verifica la respuesta final con una fuente o prueba independiente |
| Descargar cualquier archivo con “R1” en el nombre | Comprueba autor, licencia, modelo base y procedencia |
Checklist antes de elegir una versión
- ¿Necesitas realmente R1 o solo el razonamiento actual de DeepSeek?
- ¿Quieres utilizar un servicio alojado o ejecutar los pesos tú mismo?
- ¿El modelo elegido es R1 completo, R1-0528, Distill o una conversión?
- ¿Conoces el modelo base de la variante?
- ¿Comprobaste la etiqueta y la versión exactas?
- ¿El archivo cabe en disco y el modelo cabe en memoria durante la ejecución?
- ¿Definiste un contexto razonable?
- ¿La plantilla de chat corresponde al modelo?
- ¿Revisaste la licencia del modelo y de la conversión?
- ¿Sabes dónde se procesarán y almacenarán tus datos?
- ¿Tienes una prueba que permita evaluar la calidad de las respuestas?
Preguntas frecuentes
¿DeepSeek R1 sigue siendo el modelo actual?
No. R1 continúa disponible como pesos abiertos, pero la web y la aplicación oficiales se actualizaron a DeepSeek-V4.1-Flash-1017 en octubre de 2026. La API actual ofrece deepseek-flash y deepseek-v4-pro.
¿R1 y DeepThink son lo mismo?
En el lanzamiento de enero de 2025, DeepThink permitía utilizar R1 en la web. Después, DeepSeek conservó el concepto de pensamiento en modelos posteriores. El nombre del control ya no demuestra que el modelo subyacente sea R1.
¿Sigue funcionando deepseek-reasoner?
No figura entre los modelos actuales de la API. DeepSeek anunció su retirada para el 24 de julio de 2026. Actualiza las integraciones a deepseek-flash o deepseek-v4-pro y activa Thinking Mode cuando lo necesites.
¿DeepSeek R1 es gratis?
Los pesos oficiales se publican bajo licencia MIT y pueden descargarse sin una tarifa de licencia. Esto no elimina el costo de hardware, almacenamiento, electricidad, alojamiento o soporte. La API oficial funciona con facturación por uso.
¿Puede utilizarse sin internet?
Sí, después de descargar un modelo compatible puedes ejecutar la inferencia localmente sin conexión. Debes asegurarte de que la interfaz no dependa de la nube ni active búsquedas, herramientas o servicios remotos.
¿El modelo de 8B es el R1 completo?
No. Las variantes de 8B son modelos separados. El Distill original de 8B se basa en Llama 3.1, mientras que la variante posterior R1-0528-Qwen3-8B se basa en Qwen3. El R1 completo tiene 671B parámetros totales.
¿Cuánta RAM necesita DeepSeek R1?
No existe una cifra única. Depende del modelo, cuantización, motor, contexto, caché y distribución entre CPU y GPU. El tamaño de descarga no equivale al consumo total durante la ejecución.
¿DeepSeek R1 puede utilizarse comercialmente?
DeepSeek publica la familia principal bajo MIT y permite uso comercial y obras derivadas. Debes revisar también la licencia del modelo base en las variantes Qwen o Llama y cualquier condición de la conversión que descargues.
¿DeepSeek R1 es de código abierto?
DeepSeek lo presenta como abierto y publica el repositorio y los pesos bajo MIT. Si tu organización utiliza una definición que exige datos completos de entrenamiento, código de infraestructura y todos los componentes reproducibles, evalúa exactamente qué materiales fueron publicados antes de clasificarlo.
¿Una cadena de razonamiento visible demuestra que la respuesta es correcta?
No. Un modelo puede producir una explicación extensa y coherente basada en un supuesto incorrecto. Revisa el resultado final mediante cálculos, pruebas, documentación o fuentes independientes.
Fuentes oficiales consultadas
- Anuncio oficial de DeepSeek-R1.
- Repositorio oficial de DeepSeek-R1.
- Ficha oficial de DeepSeek-R1 en Hugging Face.
- Anuncio oficial de DeepSeek-R1-0528.
- Ficha oficial de DeepSeek-R1-0528.
- Registro oficial de cambios de DeepSeek.
- Lista actual de modelos de la API.
- Documentación oficial de Thinking Mode.
- Catálogo de DeepSeek R1 en Ollama.
- Política de privacidad de DeepSeek.