
Para instalar y usar DeepSeek localmente necesitas dos elementos: un programa que ejecute modelos, como Ollama o LM Studio, y los archivos de un modelo compatible. Instalar solo la aplicación oficial de DeepSeek o abrir su sitio web no constituye una ejecución local.
La ruta más directa de esta guía utiliza Ollama y la etiqueta local deepseek-r1:8b. Es un modelo destilado de 8 mil millones de parámetros, no el DeepSeek-R1 completo de 671 mil millones. Si tu computadora no puede cargarlo, puedes repetir los mismos pasos con deepseek-r1:1.5b.
Información verificada el 10 de noviembre de 2026.
Qué significa ejecutar DeepSeek localmente
Ejecutar un modelo localmente significa que sus pesos están almacenados en tu computadora y que el procesamiento de cada prompt se realiza mediante tu CPU, GPU o memoria unificada. El modelo no necesita enviar la solicitud a la API alojada de DeepSeek para generar la respuesta.
Esto es diferente de las siguientes situaciones:
- Abrir
chat.deepseek.comdesde el navegador. - Utilizar la aplicación oficial de DeepSeek conectada a sus servidores.
- Enviar solicitudes a la API oficial de DeepSeek.
- Ejecutar una interfaz de escritorio que se conecta a un modelo alojado en la nube.
- Usar una etiqueta de Ollama terminada en
:cloud. - Conectarte a un modelo instalado en otra computadora de la red.
Una instalación local tiene dos partes separadas:
- Runtime: el programa que carga el modelo, administra la memoria y genera las respuestas. En esta guía utilizaremos Ollama y LM Studio.
- Modelo: los archivos de pesos, el tokenizer, la configuración y la plantilla necesarios para ejecutar una versión concreta.
Ollama o LM Studio no incluyen automáticamente todos los modelos de DeepSeek. Primero instalas el runtime y después eliges y descargas un modelo específico.
Ollama o LM Studio: cuál conviene elegir
| Opción | Resulta adecuada para | Ventaja principal | Precaución |
|---|---|---|---|
| Ollama | Usuarios que aceptan utilizar Terminal, PowerShell o una API local. | Instalación directa, comandos cortos y servidor local integrado. | Debes comprobar que la etiqueta elegida sea local y no termine en :cloud. |
| LM Studio | Personas que prefieren una interfaz gráfica para buscar, descargar y cargar modelos. | Muestra modelos, memoria estimada, chat y servidor local dentro de una aplicación. | Muchos archivos GGUF son cuantizaciones de terceros; debes revisar su origen y licencia. |
| vLLM o SGLang | Servidores, equipos técnicos e implementaciones con varias GPU. | Más control sobre inferencia, concurrencia y despliegue. | No es la ruta más simple para una primera instalación en una computadora personal. |
Ollama será el camino principal porque permite reproducir la instalación con pocos comandos. LM Studio aparece después como alternativa gráfica y no necesita compartir los mismos archivos descargados por Ollama.
Qué modelo DeepSeek debes descargar
El nombre “DeepSeek-R1” se utiliza para una familia de modelos. El modelo completo tiene 671 mil millones de parámetros, mientras que las versiones de 1.5B, 7B, 8B, 14B, 32B y 70B son modelos destilados o derivados más pequeños.
La destilación utiliza resultados o patrones de un modelo mayor para ajustar otro modelo más pequeño. No equivale a comprimir el modelo completo sin cambiar su identidad.
| Etiqueta de Ollama | Descarga aproximada | Tipo | Uso orientativo |
|---|---|---|---|
deepseek-r1:1.5b | 1.1GB | Distill basado en Qwen | Comprobar la instalación o trabajar en un equipo con memoria limitada. |
deepseek-r1:7b | 4.7GB | Distill basado en Qwen | Chat y razonamiento básico con un archivo relativamente pequeño. |
deepseek-r1:8b | 5.2GB | DeepSeek-R1-0528-Qwen3-8B | Punto de partida de esta guía cuando el equipo dispone de memoria suficiente. |
deepseek-r1:14b | 9.0GB | Distill basado en Qwen | Tareas más exigentes en una computadora con mayor capacidad. |
deepseek-r1:32b | 20GB | Distill basado en Qwen | Workstation o servidor con memoria considerable. |
deepseek-r1:70b | 43GB | Distill basado en Llama | Hardware de alta capacidad o despliegue dividido entre CPU y GPU. |
deepseek-r1:671b | 404GB | DeepSeek-R1 completo | Infraestructura de servidor; no es una opción normal para una computadora personal. |
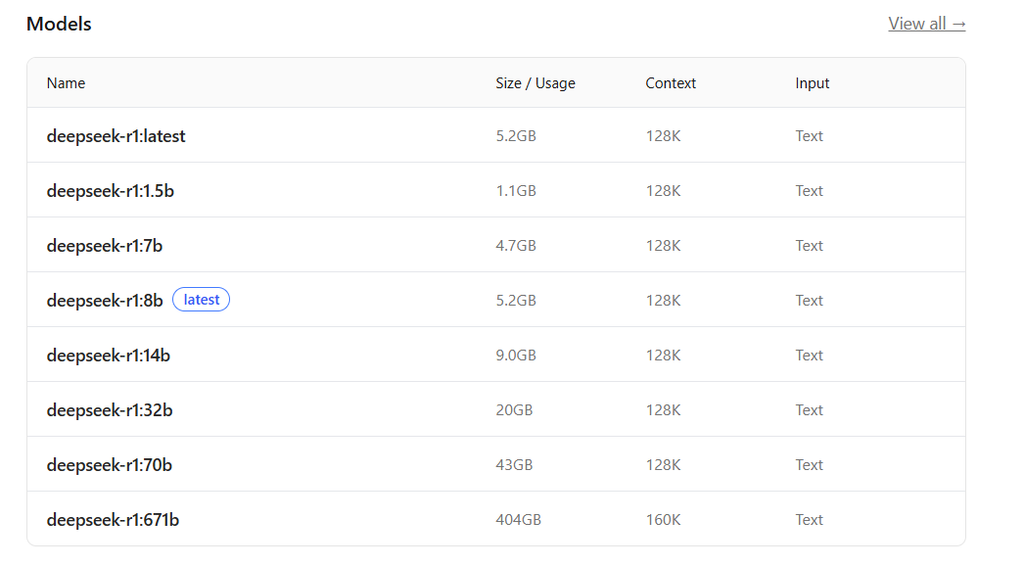
El tamaño de la descarga no es igual a la memoria total necesaria. El runtime también necesita memoria para el contexto, el KV cache, los buffers y otras operaciones. Una etiqueta que ocupa 5.2GB en el disco puede necesitar más memoria durante la generación.
Evita utilizar deepseek-r1:latest en un tutorial que deba ser reproducible. Actualmente apunta a la variante de 8B, pero un alias llamado latest puede cambiar en el futuro. Utiliza una etiqueta explícita como deepseek-r1:8b.
Comprueba tu computadora antes de instalar el modelo
- Confirma si tu sistema es Windows, macOS o Linux y revisa su versión.
- Comprueba si la arquitectura es x64, ARM64 o Apple Silicon.
- Revisa la RAM disponible después de cerrar programas pesados.
- Identifica la GPU y la cantidad de VRAM o memoria unificada.
- Comprueba el espacio libre en el disco.
- Decide si necesitas una conversación corta o un contexto largo.
- Define si utilizarás solo chat o también programación, documentos o una API local.
- Verifica que el runtime elegido admita tu CPU, GPU y sistema operativo.
No existe una cifra de RAM válida para todos los modelos. La memoria requerida cambia con la etiqueta, la cuantización, la longitud del contexto, el porcentaje cargado en GPU y el runtime.
Una estrategia segura consiste en empezar con deepseek-r1:1.5b para comprobar la instalación. Después puedes probar deepseek-r1:8b y observar el consumo real antes de descargar una variante mayor.
Cómo instalar DeepSeek localmente con Ollama
Ollama funciona en Windows, macOS y Linux. Las instrucciones siguientes utilizan la instalación oficial y una etiqueta local que no incluye el sufijo :cloud.
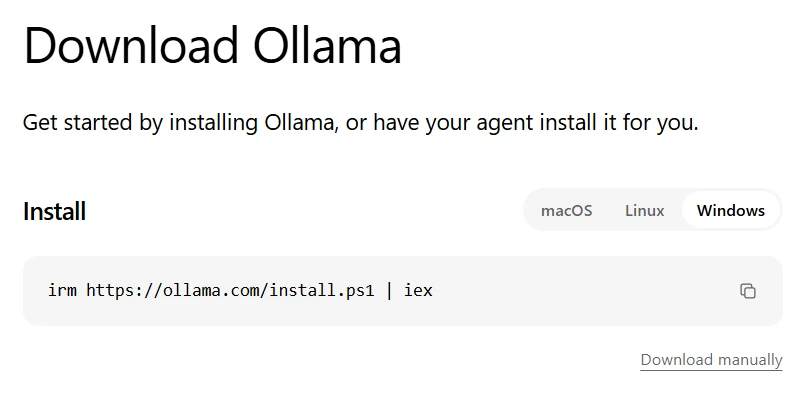
1. Instala Ollama en Windows
Ollama admite Windows 10 22H2 o una versión posterior. Puedes descargar OllamaSetup.exe desde la página oficial de Ollama o ejecutar el instalador oficial desde PowerShell:
irm https://ollama.com/install.ps1 | iexDespués de instalarlo, Ollama se ejecuta en segundo plano y el comando ollama queda disponible en PowerShell, CMD o Windows Terminal.
2. Instala Ollama en macOS
La documentación actual de Ollama requiere macOS Sonoma 14 o posterior. Descarga el archivo DMG oficial, ábrelo y mueve Ollama a la carpeta Aplicaciones. La aplicación puede solicitar permiso para añadir el comando a /usr/local/bin.
Ollama utiliza Metal para acelerar la inferencia en dispositivos Apple compatibles. Los Mac con procesador Intel pueden recurrir a CPU, pero el rendimiento y la compatibilidad no son iguales a los de Apple Silicon.
3. Instala Ollama en Linux
Ejecuta el script de instalación oficial:
curl -fsSL https://ollama.com/install.sh | shEn una instalación administrada mediante systemd, inicia y comprueba el servicio con:
sudo systemctl start ollama
sudo systemctl status ollama
Si instalaste Ollama manualmente y no existe un servicio, puedes iniciar el servidor en una terminal:
ollama serve4. Verifica la instalación
ollama -vSi el sistema indica que el comando no existe, cierra y vuelve a abrir la terminal. En Windows y macOS, comprueba también que la aplicación de Ollama esté abierta.
5. Descarga una etiqueta local de DeepSeek-R1
El ejemplo principal utiliza la variante de 8B:
ollama pull deepseek-r1:8bEn un equipo con menos memoria, utiliza:
ollama pull deepseek-r1:1.5bLa descarga se realiza una sola vez para esa etiqueta. Las actualizaciones del modelo requieren ejecutar nuevamente ollama pull.
6. Comprueba que el modelo está almacenado localmente
ollama lsBusca deepseek-r1:8b en la lista. Una etiqueta terminada en :cloud utiliza la infraestructura de Ollama y no representa un modelo almacenado y ejecutado íntegramente en tu equipo.
7. Inicia la conversación
ollama run deepseek-r1:8bCuando aparezca el indicador de entrada, envía este prompt:
Ordena 17, 4 y 12 de menor a mayor y calcula la suma. Responde en español latino neutro.
El orden correcto es 4, 12 y 17, y la suma es 33. Este ejercicio confirma que el modelo genera una respuesta coherente, pero todavía no demuestra por sí solo que la inferencia sea local.
Cómo comprobar que DeepSeek realmente se ejecuta localmente
No confíes en una sola señal. Que una aplicación use localhost o que el modelo diga “soy local” no prueba dónde se ejecutó la inferencia.
- Confirma que utilizas una etiqueta sin
:cloud. - Ejecuta
ollama lsy verifica que el modelo tenga archivos almacenados localmente. - Inicia el modelo y ejecuta
ollama psdesde otra terminal. - Revisa las columnas
PROCESSORyCONTEXT. - Observa el uso de CPU, GPU y memoria desde el administrador del sistema.
- Desconecta temporalmente Internet después de completar la descarga.
- Envía un prompt nuevo que no se haya solicitado antes.
- Comprueba que recibes una respuesta sin que se restablezca la conexión.
ollama psLa columna PROCESSOR puede mostrar que el modelo se encuentra totalmente en GPU, totalmente en CPU o dividido entre ambas. Una división entre CPU y GPU es válida, pero puede ser más lenta que cargar el modelo completo en la memoria de la tarjeta gráfica.
Para una comprobación adicional, cierra la sesión de Ollama si alguna vez utilizaste sus modelos cloud:
ollama signoutDespués, desconecta la red y vuelve a ejecutar ollama run deepseek-r1:8b. Si el modelo ya está descargado y responde a una consulta nueva, tienes evidencia práctica de inferencia local.
Cómo usar DeepSeek localmente con LM Studio
LM Studio ofrece una ruta gráfica para descargar modelos, cargarlos en la memoria, mantener conversaciones y ejecutar un servidor local. Está disponible para Windows, macOS y Linux, aunque sus requisitos dependen del sistema.
- macOS: Apple Silicon y macOS 14 o posterior. La documentación recomienda 16GB de RAM o más.
- Windows: x64 o ARM. Los equipos x64 necesitan soporte AVX2; se recomiendan al menos 16GB de RAM y 4GB de VRAM dedicada.
- Linux: x64 o ARM64. La aplicación se distribuye como AppImage y la documentación indica Ubuntu 20.04 o posterior.
Estas son recomendaciones de la aplicación LM Studio, no una garantía de que cualquier modelo DeepSeek funcione con esa memoria.
- Descarga LM Studio desde su página oficial.
- Instala la aplicación y abre la sección Discover.
- Busca el nombre completo del modelo, por ejemplo
DeepSeek-R1-Distill-Qwen. - Comprueba el editor del repositorio, el número de parámetros, el formato y la cuantización.
- Elige una variante que la aplicación marque como compatible con tu memoria disponible.
- Descarga el archivo.
- Abre la sección de chat y carga el modelo en la memoria.
- Ajusta el contexto a un valor moderado para la primera prueba.
- Envía un prompt en español y observa la memoria utilizada.
Los archivos GGUF mostrados en LM Studio suelen ser cuantizaciones. Revisa quién publicó el repositorio: una cuantización comunitaria puede ser útil, pero no debe presentarse como un archivo oficial de DeepSeek salvo que proceda de su organización verificada.
Qué funciona sin Internet en LM Studio
Después de descargar el modelo y el runtime, LM Studio documenta que el chat, el servidor local y el trabajo con documentos mediante RAG pueden funcionar sin conexión. Buscar modelos, descargarlos, obtener runtimes y comprobar actualizaciones sí requiere Internet.
Cómo hacer que DeepSeek responda en español
La interfaz local no determina automáticamente la lengua de todas las respuestas. Indica el idioma y el estilo en el prompt:
Responde en español latino neutro. Utiliza párrafos breves, explica los términos técnicos y señala cualquier dato que no puedas verificar.
La calidad del español depende del checkpoint. Un modelo Distill basado en Qwen puede comportarse de forma diferente de una variante basada en Llama, aunque ambos utilicen el nombre DeepSeek-R1.
Si el modelo cambia de idioma durante la respuesta, repite la instrucción al comienzo de un chat nuevo y evita mezclar varias lenguas en el mismo prompt.
Cómo utilizar la API local de Ollama
Ollama expone su API local en http://localhost:11434/api. Las solicitudes locales no necesitan una clave de DeepSeek ni consumen créditos de su API oficial.
Este ejemplo utiliza únicamente la biblioteca estándar de Python e incluye manejo básico de errores:
import json
import urllib.error
import urllib.request

payload = {
    "model": "deepseek-r1:8b",
    "messages": [
        {
            "role": "user",
            "content": (
                "Responde en español latino neutro. "
                "Explica en tres puntos qué es una API local."
            ),
        }
    ],
    "stream": False,
}

request = urllib.request.Request(
    "http://localhost:11434/api/chat",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
    method="POST",
)

try:
    with urllib.request.urlopen(request, timeout=120) as response:
        result = json.load(response)
except urllib.error.HTTPError as exc:
    raise SystemExit(
        f"Ollama devolvió HTTP {exc.code}: {exc.reason}"
    ) from exc
except urllib.error.URLError as exc:
    raise SystemExit(
        "No se pudo conectar con Ollama. "
        "Comprueba que la aplicación o el servicio estén activos."
    ) from exc

print(result["message"]["content"])
Si aparece connection refused, comprueba que Ollama esté ejecutándose. En Windows y macOS, abre la aplicación. En una instalación manual puedes iniciar el servidor con ollama serve.
Protege la API local
Las solicitudes al servidor local de Ollama no requieren autenticación de forma predeterminada. Esto es cómodo en localhost, pero puede convertirse en un riesgo si expones el puerto a otros dispositivos o a Internet.
- Mantén el servidor escuchando solo en
localhostsi no necesitas compartirlo. - No configures
OLLAMA_HOST=0.0.0.0:11434sin entender las consecuencias. - No abras el puerto 11434 directamente en el router.
- Utiliza firewall, autenticación y un reverse proxy si compartes el servidor.
- No introduzcas información sensible en la primera prueba.
- Revisa los logs, el historial y las herramientas conectadas.
LM Studio también permite iniciar un servidor desde la pestaña Developer y puede ofrecer endpoints compatibles con OpenAI. Conserva la configuración en localhost mientras no necesites acceso desde la red.
Contexto, memoria y velocidad
La longitud de contexto es la cantidad máxima de tokens que el runtime mantiene disponibles para el modelo durante una solicitud. Aumentarla permite procesar conversaciones o documentos más largos, pero incrementa el consumo de memoria.
La documentación actual de Ollama asigna un contexto predeterminado según la VRAM disponible. No debes asumir que utilizará automáticamente los 128K indicados en la página del modelo.
Comprueba el contexto realmente asignado con:
ollama psDentro de una sesión de ollama run, puedes ajustar el contexto con:
/set parameter num_ctx 8192Empieza con un valor moderado. Si el sistema se queda sin memoria, reduce el contexto antes de cambiar todo el modelo.
- Un contexto mayor consume más RAM o VRAM.
- La cuantización modifica el tamaño y puede afectar la calidad.
- La ejecución completa en CPU suele ser más lenta.
- Dividir el modelo entre CPU y GPU puede permitir que funcione, pero reduce el rendimiento.
- Cerrar aplicaciones pesadas libera memoria para el modelo.
- Un modelo más grande no siempre produce una respuesta más útil para tu tarea.
Archivos, RAG y búsqueda web
Un modelo descargado no obtiene acceso automático a Internet, tus carpetas, correo, calendario o documentos. Estas funciones requieren una interfaz o una herramienta adicional.
LM Studio permite conversar con documentos mediante RAG y documenta que el procesamiento puede mantenerse local después de descargar los componentes necesarios. El sistema utiliza el documento como contexto, pero no significa que el modelo memorice permanentemente todo su contenido.
La búsqueda web requiere una herramienta conectada. Si añades un buscador, un servidor MCP, un plugin o una API externa, parte de la información puede salir del dispositivo aunque la generación principal siga realizándose localmente.
Privacidad: local no significa automáticamente privado
La inferencia local puede reducir el envío de prompts a un proveedor externo, pero la privacidad depende de todo el sistema.
- La interfaz puede guardar conversaciones en el disco.
- Los logs pueden contener metadatos o errores.
- Una carpeta sincronizada puede copiar archivos a la nube.
- Los plugins pueden conectarse a servicios externos.
- Una etiqueta
:cloudprocesa la solicitud fuera del equipo. - Un servidor expuesto en la red puede aceptar solicitudes no autorizadas.
- Una interfaz comunitaria puede aplicar una política de privacidad distinta.
Para trabajar con contenido confidencial, revisa el runtime, la interfaz, las herramientas conectadas, los logs, la ubicación de almacenamiento y la configuración de red.
Problemas frecuentes al instalar DeepSeek localmente
| Problema | Comprobación | Solución recomendada |
|---|---|---|
ollama no se reconoce | Ejecuta el comando desde una terminal nueva. | Reinicia la aplicación, comprueba el PATH o reinstala desde la página oficial. |
| La etiqueta no existe | Compara el nombre con la biblioteca oficial de Ollama. | Utiliza el nombre completo, por ejemplo deepseek-r1:8b. |
| El modelo no aparece | Ejecuta ollama ls. | Repite ollama pull y revisa los errores de red o espacio. |
| Falta memoria | Revisa RAM, VRAM, contexto y programas abiertos. | Reduce el contexto o utiliza deepseek-r1:1.5b. |
| La respuesta es muy lenta | Ejecuta ollama ps y revisa PROCESSOR. | Prueba una etiqueta menor, cierra programas o corrige la aceleración GPU. |
| Solo utiliza CPU | Revisa ollama ps y los logs. | Actualiza drivers y consulta la lista oficial de GPU compatibles. |
connection refused | Comprueba si Ollama está activo. | Abre la aplicación o ejecuta ollama serve. |
| El modo offline falla | Revisa si la etiqueta termina en :cloud. | Descarga una etiqueta local y comprueba que aparezca con tamaño en ollama ls. |
| Responde en otro idioma | Abre un chat nuevo. | Especifica “Responde en español latino neutro” al inicio. |
| El contexto es menor de lo esperado | Consulta la columna CONTEXT en ollama ps. | Auméntalo gradualmente y vigila el consumo de memoria. |
No elimines todos los directorios de Ollama o LM Studio como primera solución. Revisa primero el mensaje de error, los logs, el modelo seleccionado y la memoria disponible.
Cómo actualizar, detener o eliminar el modelo
Actualizar los archivos de la misma etiqueta
ollama pull deepseek-r1:8bVer los modelos cargados en memoria
ollama psDetener un modelo
ollama stop deepseek-r1:8bEliminar los pesos descargados
ollama rm deepseek-r1:8bEliminar el modelo libera su espacio de almacenamiento, pero no equivale necesariamente a eliminar historiales, logs o datos guardados por otras interfaces conectadas.
Licencia y uso comercial
El repositorio oficial de DeepSeek-R1 publica el código y los pesos bajo MIT y permite uso comercial, modificaciones y derivados. Sin embargo, los modelos Distill también proceden de modelos base de Qwen o Llama.
Las variantes basadas en Qwen incorporan condiciones de Apache 2.0, mientras que las basadas en Llama están vinculadas a la licencia correspondiente de Llama. Revisa el checkpoint exacto, la cuantización y el runtime antes de integrarlos en un producto.
Preguntas frecuentes
¿Necesito una cuenta de DeepSeek?
No para ejecutar una copia local mediante Ollama o LM Studio. Tampoco necesitas una clave de la API de DeepSeek. Los modelos cloud de Ollama sí pueden requerir iniciar sesión en Ollama.
¿Ollama instala DeepSeek automáticamente?
No. Ollama instala el runtime. Debes descargar después una etiqueta concreta con ollama pull o iniciar la descarga mediante ollama run.
¿La versión de 8B es DeepSeek-R1 completo?
No. La etiqueta actual deepseek-r1:8b corresponde a un modelo destilado de 8B. El modelo completo tiene 671B y su archivo de Ollama es mucho mayor.
¿Se puede usar DeepSeek local sin GPU?
Algunos modelos pueden ejecutarse en CPU, pero la velocidad depende del tamaño, la cuantización, el procesador, la memoria y el contexto. Empieza con una etiqueta pequeña y revisa el rendimiento real.
¿Usar localhost demuestra que el modelo es local?
No por sí solo. Un programa local puede reenviar solicitudes a la nube. Comprueba la etiqueta, los archivos descargados, ollama ps, el uso del hardware y el funcionamiento con la red desconectada.
¿DeepSeek local puede buscar en Internet?
No automáticamente. Necesita una herramienta de búsqueda o una integración externa. Esa herramienta puede enviar consultas fuera del dispositivo.
¿El uso local consume créditos de DeepSeek API?
No cuando la inferencia se realiza con pesos descargados en tu hardware. Aun así, existen costos de almacenamiento, electricidad, mantenimiento y equipo.
¿Cuál es mejor: Ollama o LM Studio?
Ollama resulta práctico para comandos, automatización y API local. LM Studio ofrece una interfaz visual para buscar, cargar y probar modelos. La elección depende de si prefieres Terminal o una aplicación gráfica.
Fuentes oficiales consultadas
- Repositorio oficial de DeepSeek-R1: modelos completos, variantes Distill y licencias.
- Biblioteca oficial DeepSeek-R1 de Ollama: etiquetas, tamaños y comandos actuales.
- Descarga oficial de Ollama: instaladores para Windows, macOS y Linux.
- Referencia oficial de la CLI de Ollama: comandos para ejecutar, listar, detener y eliminar modelos.
- Introducción a la API de Ollama: servidor local, URL base y autenticación.
- Documentación del contexto de Ollama: asignación, memoria y verificación.
- Soporte de hardware de Ollama: NVIDIA, AMD, Apple Metal y Vulkan.
- Requisitos oficiales de LM Studio: sistemas, CPU, RAM y GPU.
- Funcionamiento offline de LM Studio: modelos, documentos, servidores y operaciones que requieren Internet.
- Servidor local de LM Studio: REST API y compatibilidad con OpenAI y Anthropic.