
DeepSeek Context Caching reutiliza procesamiento de partes iniciales de una entrada que la API ya almacenó. Está activada automáticamente: envías solicitudes normales y compruebas qué tokens aprovecharon la caché mediante los datos de usage. Los tokens de entrada con cache hit tienen una tarifa distinta de los que registran cache miss.
Esta función resulta útil cuando varias consultas comparten instrucciones, documentos o historial. Para evaluar su beneficio, necesitas comprobar qué parte se reutilizó y calcular el costo completo, incluidos los tokens de salida. Una solicitud parecida o una respuesta rápida no bastan para confirmar un acierto.
La guía se centra en la API oficial alojada en DeepSeek. Su presentación de Context Caching on Disk explica la reutilización del procesamiento de entrada; para las reglas y tarifas vigentes, consulta la guía de caché y la tabla de precios.
Cuándo se produce un cache hit
Un prefijo es el comienzo de la entrada. DeepSeek requiere que coincida completamente con una unidad ya persistida en caché. La guía actual describe unidades creadas en límites de entrada y salida, por detección de comienzos comunes y a intervalos de tokens en secuencias largas. No publica allí un tamaño numérico universal para esos intervalos.
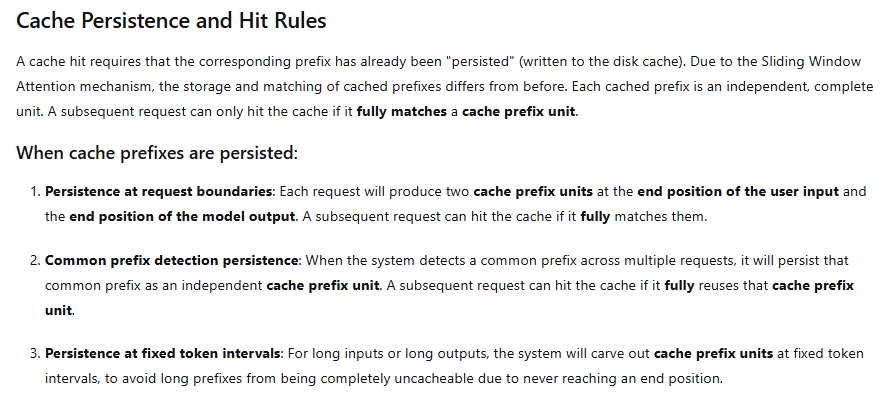
Supón que envías un manual estable y cambias la pregunta final. Este es el mecanismo conceptual, no una predicción de los contadores de cada llamada:
| Solicitud | Qué puede ocurrir |
|---|---|
| Manual + pregunta sobre horarios | Se establece una unidad que incluye esa entrada. |
| Mismo manual + pregunta sobre requisitos | El comienzo común puede detectarse y persistirse; compartir el manual no asegura reutilizar inmediatamente esa unidad. |
| Mismo manual + pregunta sobre devoluciones | Puede reutilizar el comienzo común si la unidad correspondiente ya está disponible. |
Una conversación que conserva la secuencia anterior y añade otro turno puede reutilizar un prefijo completo. En todos los casos, DeepSeek describe un funcionamiento de mejor esfuerzo: no garantiza un acierto en cada solicitud. Estas condiciones aparecen en su explicación de las unidades de prefijo.
Cache miss no significa que la solicitud haya fallado. Identifica tokens de entrada que no se atendieron desde la caché y se cobran a la tarifa correspondiente. Reenviar la consulta hasta conseguir un hit añade llamadas y consumo; primero revisa la estructura de tu solicitud y los contadores.
Qué relación tiene la caché con el historial y la respuesta
El modelo sigue generando una respuesta nueva. Reutilizar procesamiento de entrada no equivale a recuperar un texto final guardado. Por eso, dos solicitudes con aciertos de caché pueden producir salidas diferentes.
Tu aplicación también debe seguir enviando el contexto necesario. La guía de conversaciones de varios turnos indica que Chat Completions funciona sin estado de conversación almacenado para recuperar automáticamente el historial. Responses exige igualmente enviar el contexto en cada solicitud, como señala su referencia oficial.
Los tokens reutilizados siguen siendo parte de la entrada. La caché reduce el trabajo y la tarifa aplicable a una parte de esos tokens; no amplía la ventana de contexto. Si tu historial crece demasiado, selecciona o resume el material relevante antes de enviarlo. Esa decisión puede cambiar el prefijo reutilizable, pero debe conservar la información necesaria para responder bien.
Cómo comprobar cache hits y misses en la API
Los contadores de Chat Completions
Examina usage en la respuesta. La referencia de Chat Completions documenta estos campos:
| Campo | Qué representa |
|---|---|
prompt_tokens | Total de tokens de entrada. |
prompt_cache_hit_tokens | Tokens de entrada que aprovecharon la caché. |
prompt_cache_miss_tokens | Tokens de entrada que no aprovecharon la caché. |
prompt_tokens_details.cached_tokens | El mismo número de tokens con hit; no es una categoría adicional. |
completion_tokens | Tokens generados en la salida. |
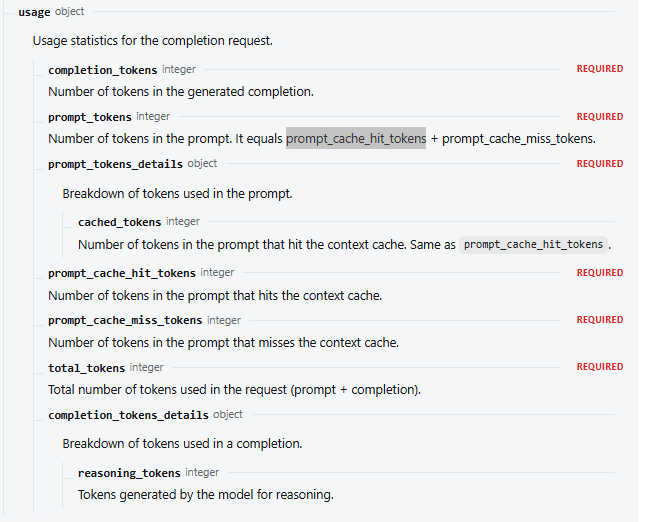
La relación documentada es prompt_tokens = prompt_cache_hit_tokens + prompt_cache_miss_tokens. Para una solicitud con entrada mayor que cero:
Tasa de aciertos por tokens = 100 × tokens con hit / tokens de entradaNo sumes cached_tokens y prompt_cache_hit_tokens: duplicarías el mismo consumo. Tampoco reemplaces un campo ausente por cero. Un cero es una medición; un dato ausente es información no disponible.
Para obtener la tasa de un conjunto de solicitudes, suma primero todos los hits y todos los tokens de entrada. Después divide ambos totales. Un promedio simple de porcentajes por llamada puede distorsionar el resultado cuando las entradas tienen tamaños distintos.
Si utilizas Responses o el formato compatible con Anthropic
Los nombres y el significado de los contadores cambian según el formato. Usa el denominador correspondiente:
| Formato de DeepSeek | Entrada total | Tokens con hit |
|---|---|---|
| Chat Completions | usage.prompt_tokens | usage.prompt_cache_hit_tokens |
| Responses | usage.input_tokens | usage.input_tokens_details.cached_tokens |
| Messages compatible con Anthropic | input_tokens + cache_read_input_tokens + cache_creation_input_tokens, dentro de usage | usage.cache_read_input_tokens |
En Responses, los tokens en caché forman parte de input_tokens. En el formato compatible con Anthropic, input_tokens excluye los hits y cache_creation_input_tokens se reporta actualmente como cero. Una fórmula compartida sin adaptar esos campos puede producir porcentajes y estimaciones incorrectos.
Con streaming, captura el consumo final: el último fragmento de contenido de Chat Completions, antes de [DONE]; el objeto de respuesta del evento terminal de Responses; o message_delta.usage en el formato Anthropic. En este último caso, no sumes los contadores iniciales a los finales. Si una interrupción impide recibirlos, registra el consumo como desconocido.
Ejemplo en Python para medir la reutilización
El siguiente programa realiza como máximo dos solicitudes. Usa un manual ficticio, conserva la primera respuesta del asistente y añade una pregunta. Así, la segunda llamada extiende la conversación existente. El programa informa lo que devuelve la API: no presupone que la primera llamada tenga cero hits ni que la segunda deba tenerlos.
Necesitas una clave de la plataforma de DeepSeek y Python 3.10 o superior, según los requisitos actuales del SDK oficial de OpenAI para Python. Instala el cliente en tu entorno:
python -m pip install --upgrade openaiConfigura tu clave en la misma terminal donde ejecutarás el archivo. En macOS o Linux:
export DEEPSEEK_API_KEY="TU_CLAVE_DEEPSEEK"En Windows PowerShell:
$env:DEEPSEEK_API_KEY="TU_CLAVE_DEEPSEEK"Guarda el código como medir_cache_deepseek.py. La clave se lee desde el entorno y no se imprime:
"""Realiza hasta dos solicitudes para observar el uso real de la caché."""

import os
import time

from openai import APIError, APIStatusError, OpenAI

PAUSE_SECONDS = 3  # Pausa del ejemplo; no garantiza que la caché esté disponible.
MANUAL = """Manual ficticio del Taller Nube.
El taller presta equipos para proyectos educativos. Abre de lunes a viernes,
de 9:00 a 17:00. Cada solicitud debe indicar el nombre del proyecto, el equipo
necesario, la fecha de retiro y la fecha de devolución. El equipo de recepción
revisa las solicitudes al inicio y al final de cada jornada.
Si falta información, la solicitud queda pendiente y se pide completar los
datos. El equipo no se reserva mientras la solicitud siga incompleta. Cuando
todos los datos están presentes, recepción comprueba la disponibilidad y envía
una confirmación. Una solicitud enviada todavía no equivale a una reserva.
Al retirar el equipo, la persona revisa su estado junto con recepción. Ambos
registran los accesorios entregados y cualquier daño previo. Durante el préstamo,
los equipos deben permanecer en el espacio autorizado. Si aparece una falla,
se suspende su uso y se informa al responsable del taller.
Las devoluciones se reciben durante el horario de apertura. Recepción verifica
los accesorios y actualiza el registro. Una devolución fuera de plazo requiere
contactar al taller para acordar una nueva fecha. Las excepciones quedan
documentadas y deben ser aprobadas por la coordinación."""


def consult(client, messages, number):
    response = client.chat.completions.create(
        model="deepseek-flash", messages=messages, max_tokens=256,
        extra_body={"thinking": {"type": "disabled"}},
    )
    usage = getattr(response, "usage", None)
    fields = ("prompt_cache_hit_tokens", "prompt_cache_miss_tokens",
              "prompt_tokens", "completion_tokens")
    counts = {field: getattr(usage, field, None) for field in fields}
    print(f"\nSolicitud {number}")
    for field, value in counts.items():
        print(f"{field}: {value if value is not None else 'No disponible'}")
    hit, miss, prompt = (counts[field] for field in fields[:3])
    if any(type(value) is not int or value < 0 for value in (hit, miss, prompt)):
        print("Métricas de entrada ausentes o inválidas: no se calcula la tasa.")
    elif hit + miss != prompt:
        print("Métricas inconsistentes: hit + miss no coincide con prompt_tokens.")
    elif prompt > 0:
        print(f"Porcentaje de tokens de entrada en caché: {100 * hit / prompt:.2f}%")
    else:
        print("Sin tokens de entrada: la tasa de aciertos no está definida.")
    choice = response.choices[0] if response.choices else None
    text = choice.message.content if choice else None
    if (choice is None or choice.finish_reason != "stop"
            or not isinstance(text, str) or not text.strip()):
        raise SystemExit("Respuesta incompleta o sin texto: se detiene el ejemplo.")
    print(text)
    return text  # Conserva el contenido original, incluidos sus espacios.


def main():
    key = os.environ.get("DEEPSEEK_API_KEY", "").strip()
    if not key:
        raise SystemExit("Falta la variable DEEPSEEK_API_KEY.")
    messages = [
        {"role": "system", "content": "Responde en español y usa solo el manual."},
        {"role": "user", "content": MANUAL + "\n\nResume el proceso en dos frases."},
    ]
    try:
        with OpenAI(api_key=key, base_url="https://api.deepseek.com",
                    timeout=60.0, max_retries=0) as client:
            first_text = consult(client, messages, 1)
            messages.append({"role": "assistant", "content": first_text})
            messages.append({"role": "user", "content":
                             "¿Qué ocurre si falta información en la solicitud?"})
            time.sleep(PAUSE_SECONDS)
            consult(client, messages, 2)
    except APIStatusError as error:
        raise SystemExit(f"Error HTTP: {error.status_code}.") from None
    except APIError as error:
        raise SystemExit(f"Error del SDK: {type(error).__name__}.") from None


if __name__ == "__main__":
    main()
Ejecuta el archivo:
python medir_cache_deepseek.pyCada solicitud consume tokens y se factura según sus contadores. La pausa de tres segundos es una elección didáctica: no garantiza que el prefijo ya esté disponible. El límite de 256 tokens, el timeout de 60 segundos y los reintentos desactivados también son ajustes del ejemplo, no límites generales de DeepSeek.
El ejemplo desactiva el razonamiento para mantener un historial de texto sencillo. Si tu aplicación combina razonamiento y herramientas, respeta las reglas de devolución del contexto de razonamiento; no elimines información requerida para mejorar artificialmente una métrica de caché.
Revisa los valores reales y la respuesta generada. Si faltan contadores de entrada, el programa lo indica y omite el porcentaje. Para evaluar tu aplicación, sustituye el manual ficticio por una carga representativa y mantén estables las condiciones de comparación. La longitud de este manual no representa un mínimo de tokens exigido por la API.
Cómo calcular el costo y el ahorro
Tarifas de entrada con hit, con miss y de salida
La tabla oficial de precios distingue el modelo y la franja horaria. Los importes están expresados en dólares estadounidenses (USD) por un millón de tokens:
| Modelo | Franja | Entrada: hit | Entrada: miss | Salida |
|---|---|---|---|---|
deepseek-flash | Off-peak: tarifa reducida | $0.003 | $0.15 | $0.60 |
deepseek-flash | Peak: tarifa alta | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | Off-peak: tarifa reducida | $0.022 | $0.66 | $1.98 |
deepseek-v4-pro | Peak: tarifa alta | $0.044 | $1.32 | $3.96 |
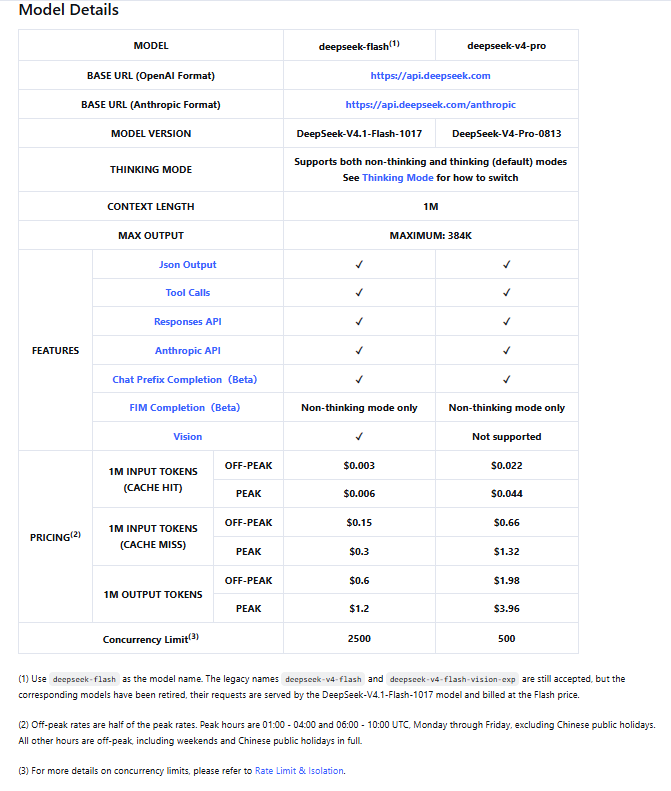
DeepSeek define actualmente las franjas peak de lunes a viernes, de 01:00 a 04:00 y de 06:00 a 10:00 UTC, excepto los días festivos de China. Los demás horarios son off-peak. Conserva la referencia UTC al comparar una factura con horarios de tu país.
Para estimar el costo de tokens de una solicitud, aplica la tarifa correspondiente a cada categoría:
Costo de tokens = (H × precio_hit + M × precio_miss + O × precio_salida) / 1 000 000Aquí, H son los tokens de entrada con hit, M los tokens de entrada con miss y O los de salida. Los tokens en caché siguen teniendo un costo. Otras operaciones facturables, si tu aplicación las utiliza, deben contabilizarse por separado.
Ejemplo hipotético: 80 % de hits no equivale a 80 % de ahorro total
Supón una solicitud de deepseek-flash con tarifas peak: 8 000 tokens con hit, 2 000 con miss y 500 de salida. Estas cantidades son un ejemplo matemático independiente del programa anterior; no son resultados observados.
| Componente | Cálculo | Costo |
|---|---|---|
| Entrada reutilizada | 8 000 × $0.006 / 1 000 000 | $0.000048 |
| Entrada sin hit | 2 000 × $0.30 / 1 000 000 | $0.000600 |
| Salida generada | 500 × $1.20 / 1 000 000 | $0.000600 |
| Total estimado | Suma de las tres categorías | $0.001248 |
Como referencia, si esos mismos 10 000 tokens de entrada se facturaran todos como miss, manteniendo los 500 de salida, el costo sería $0.003600. La diferencia sería $0.002352.
- 80 %: proporción de tokens de entrada con hit.
- 78.4 %: reducción del costo de entrada en este ejemplo.
- 65.33 %: reducción del costo total estimado de tokens, incluida la salida.
Los tres porcentajes responden preguntas distintas. Para presupuestar, utiliza el costo de toda la carga, incluidas las solicitudes iniciales que establecen contexto. Compara también un escenario conservador con menos hits; una tasa observada en una prueba no asegura el mismo resultado en todas las llamadas.
Cómo organizar tus solicitudes para favorecer la caché
Estas prácticas ayudan a mantener un comienzo reutilizable y a interpretar las mediciones. Son decisiones de diseño, no garantías de acierto:
- Coloca primero el material estable. Mantén al inicio las instrucciones y referencias que deben repetirse; sitúa después la pregunta específica de cada solicitud.
- Evita variaciones innecesarias al comienzo. Marcas de tiempo, identificadores aleatorios o texto decorativo delante del documento pueden cambiar el prefijo. Inclúyelos donde correspondan si la tarea realmente los necesita.
- Conserva una representación consistente. Para comparar solicitudes, mantén el orden de mensajes, los saltos de línea y el contenido del material compartido. Reformatearlo introduce otra variable en la prueba.
- Respeta la estructura de la conversación. Conserva las respuestas y las relaciones entre herramientas y resultados que necesita el siguiente turno.
- Incluye solo contexto útil. Añadir texto para perseguir un porcentaje mayor de hits puede aumentar el consumo y distraer al modelo. Evalúa el costo completo y la calidad de la respuesta.
Por ejemplo, si distintas consultas usan el mismo manual, prepara una versión estable del documento y añade cada pregunta al final. Si el manual cambia, conserva la versión actualizada aunque eso altere la reutilización: responder con información vigente tiene prioridad sobre mantener un contador alto.
Por qué aparecen cache misses y qué revisar
| Lo que observas | Posible explicación | Siguiente comprobación |
|---|---|---|
| El documento se repite, pero los hits son bajos. | El comienzo compartido puede no coincidir con una unidad disponible. | Compara la secuencia completa enviada y si la solicitud extiende un contexto anterior o cambia su final. |
| Cambiar una plantilla reduce los hits. | Pudo cambiar el prefijo, el orden o la representación del contenido. | Contrasta ambas versiones de la solicitud manteniendo el modelo y los demás ajustes. |
| Una repetición inmediata muestra cero hits. | La construcción o disponibilidad de la caché puede influir. | Observa llamadas útiles posteriores; evita un bucle de reintentos dedicado a forzar un hit. |
| El consumo aparece vacío o no existe el campo esperado. | Puedes estar leyendo otro formato de API, una respuesta incompleta o una pasarela. | Revisa el contrato del endpoint y registra los campos ausentes como no disponibles. |
| La tasa calculada supera el 100 %. | Puede haber un denominador incorrecto o contadores duplicados. | Comprueba el formato de API y la identidad entre entrada, hits y misses. |
| El comportamiento cambia entre usuarios. | Tu integración puede estar aplicando aislamiento de KVCache. | Revisa el identificador de usuario y mantén el aislamiento previsto para cada persona. |
Si utilizas un proveedor intermediario, verifica sus propias reglas de caché, precios y campos de respuesta. Un modelo identificado como DeepSeek no demuestra que la pasarela exponga exactamente el mismo servicio de caché que la API oficial.
Duración, controles y aislamiento de la caché
Cuánto dura y qué opciones puedes configurar
DeepSeek indica que la construcción tarda segundos y que las entradas sin uso suelen eliminarse en un plazo de horas a días. Es una descripción operativa, no un TTL garantizado. La guía vigente no ofrece una duración exacta que puedas asumir para todas las solicitudes.
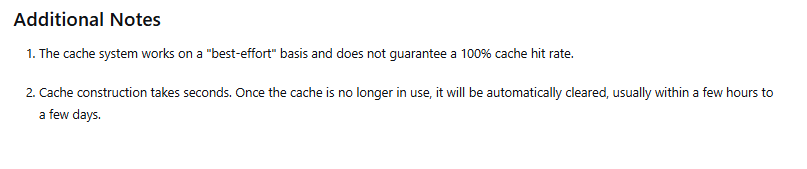
En Responses, prompt_cache_key y prompt_cache_retention no están soportados: la gestión es automática. En el formato compatible con Anthropic, las directivas cache_control documentadas se ignoran. No traslades controles de otro proveedor sin comprobar su compatibilidad en DeepSeek.
La documentación revisada no expone un control general para fijar, borrar o desactivar esta caché automática. En particular, store: false en Responses describe otra parte del contrato de la API; no funciona como interruptor de la caché de contexto.
Cómo separar usuarios dentro de una aplicación
DeepSeek documenta user_id como mecanismo de aislamiento de KVCache entre usuarios de una misma cuenta. Con Chat Completions y el SDK de OpenAI se envía dentro de extra_body. Usa identificadores opacos y evita incluir datos personales, según la guía oficial de aislamiento.
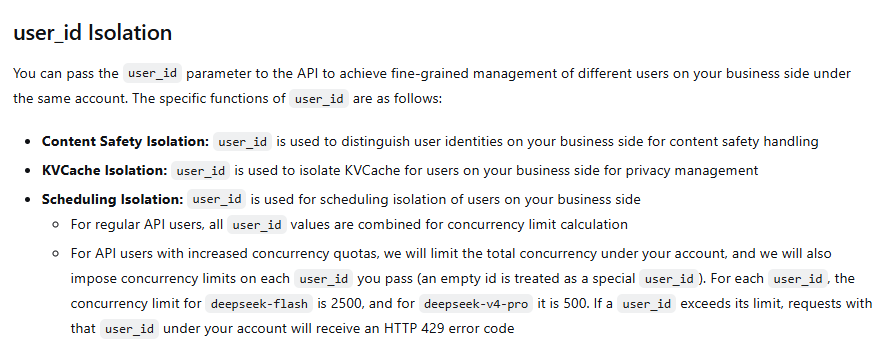
Si tu aplicación ya utiliza ese campo, conserva el identificador apropiado al continuar la conversación de una persona. No unifiques usuarios distintos solo para aumentar hits. El ejemplo de Python lo omite porque es opcional; ambas solicitudes mantienen esa misma configuración.
El plazo de eliminación de la caché y el aislamiento de usuarios no describen por sí solos toda la política de conservación de datos del servicio. Evalúa esa política por separado cuando tu aplicación lo requiera.
Qué medir antes de estimar el beneficio en tu aplicación
Prepara una muestra de tareas reales y registra el modelo, los tokens de entrada, hits, misses, salida, franja de precios y calidad del resultado. Incluye tanto solicitudes iniciales como conversaciones posteriores; excluir las primeras puede exagerar el ahorro de una carga completa.
Si también quieres evaluar velocidad, mide por separado el tiempo hasta el primer token y el tiempo total, con tareas y longitudes de salida comparables. Los contadores de usage demuestran la reutilización reportada; el cronómetro mide la experiencia de tu aplicación. Una prueba con dos solicitudes sirve para aprender a instrumentar el cliente, pero no caracteriza por sí sola su rendimiento habitual.
Usa esas mediciones para decidir qué instrucciones y documentos conviene mantener estables, cuánto historial enviar y qué presupuesto reservar cuando la caché no esté disponible.
Verificación documental: 10 de noviembre de 2026. Se revisaron las fuentes oficiales enlazadas, la sintaxis del ejemplo Python y la aritmética del ejemplo de costos. No se realizaron solicitudes autenticadas ni mediciones reales de cache hits o latencia.