
DeepSeek OCR es una familia de modelos especializados en extraer y reconstruir contenido de imágenes de documentos. El modelo original, DeepSeek-OCR, se centró en comprimir texto visual dentro de pocos tokens; DeepSeek-OCR 2 añadió DeepEncoder V2 para interpretar mejor el orden de lectura y los diseños complejos.
DeepSeek-OCR 2 sigue siendo la versión oficial más reciente verificada para esta guía. Sus pesos pueden descargarse y ejecutarse en infraestructura propia, pero no aparece como un modelo independiente en la API alojada de DeepSeek. A continuación encontrarás las diferencias entre ambas versiones, su relación con DeepSeek Vision, el flujo para imágenes y PDF, la instalación, los benchmarks y un método para revisar la calidad del resultado.
Información verificada el 10 de noviembre de 2026.
DeepSeek OCR frente a DeepSeek OCR 2
Los dos modelos comparten un decodificador Mixture of Experts orientado a OCR, pero utilizan codificadores visuales distintos. Para una evaluación nueva, OCR 2 suele ser el punto de partida más lógico; el modelo original continúa siendo útil para reproducir la investigación de compresión óptica, mantener proyectos existentes o comparar arquitecturas.
| Aspecto | DeepSeek-OCR | DeepSeek-OCR 2 |
|---|---|---|
| Publicación del repositorio | 20 de octubre de 2025 | 27 de enero de 2026 |
| Publicación del artículo | 21 de octubre de 2025 | 28 de enero de 2026 |
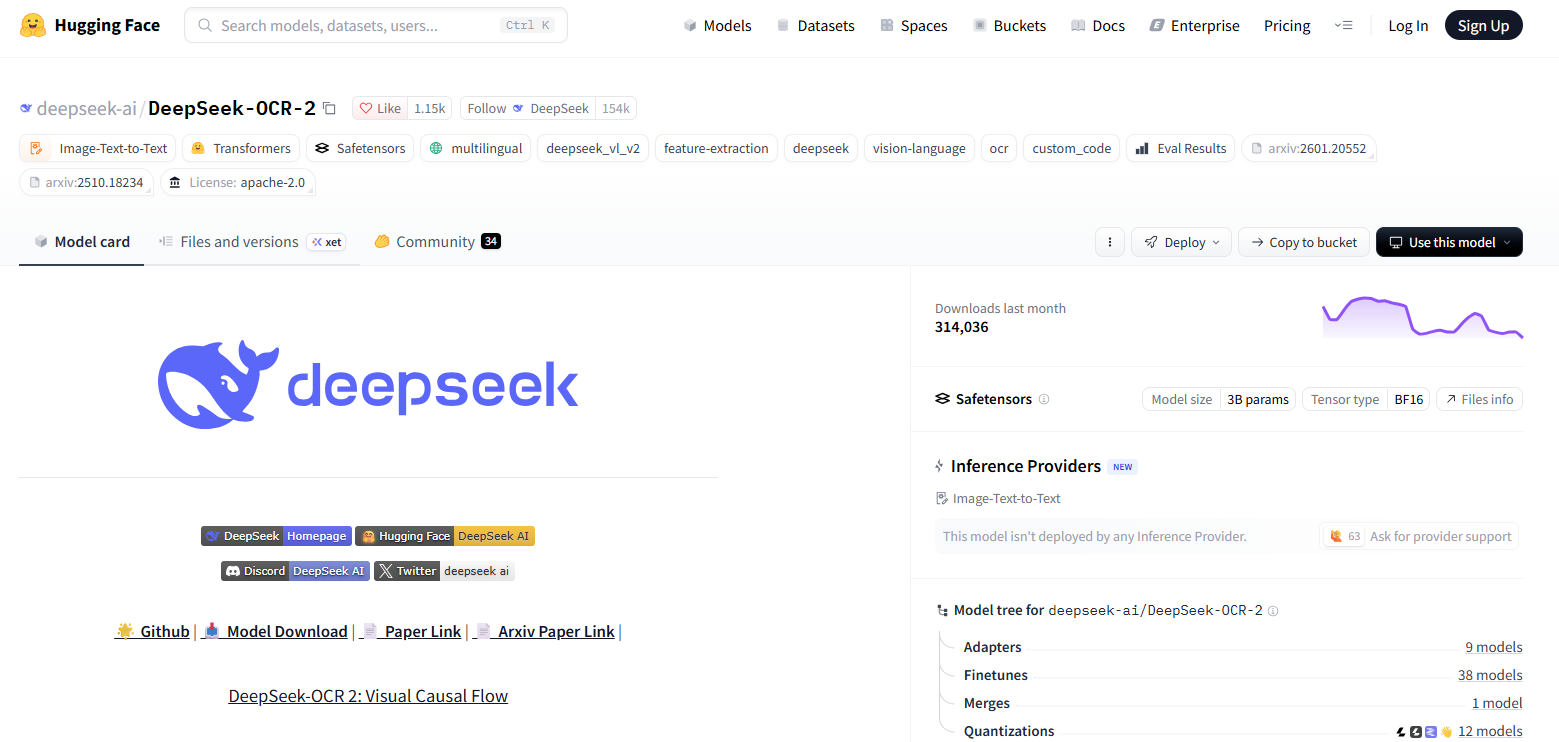
| ID oficial en Hugging Face | deepseek-ai/DeepSeek-OCR | deepseek-ai/DeepSeek-OCR-2 |
| Etiqueta de tamaño en Hugging Face | 3B, BF16 | 3B, BF16 |
| Archivo principal de pesos | Aproximadamente 6.67 GB | Aproximadamente 6.78 GB |
| Codificador | DeepEncoder | DeepEncoder V2 |
| Decodificador | DeepSeek MoE de 3B | DeepSeek MoE de 3B |
| Parámetros activos del decodificador | Alrededor de 570M | Alrededor de 500M |
| Tokens visuales | Modos nativos desde 64 hasta 400 y modo dinámico Gundam | Entre 256 y 1,120 con resolución dinámica y recortes locales |
| Objetivo principal | Compresión óptica del contexto | Reordenamiento semántico mediante Visual Causal Flow |
| Licencia del modelo oficial | MIT | Apache 2.0 |
Las fechas del repositorio y del artículo académico no son contradictorias. DeepSeek publicó cada repositorio un día antes de que apareciera su respectivo trabajo en arXiv.
¿DeepSeek OCR está disponible en la API oficial?
No como modelo alojado independiente. La lista actual de DeepSeek API muestra deepseek-flash y deepseek-v4-pro; no incluye identificadores como deepseek-ocr, deepseek-ocr-2 o DeepSeek-OCR-2.
Los identificadores de Hugging Face sirven para descargar o desplegar los pesos con herramientas como Transformers y vLLM. No pueden enviarse directamente al endpoint https://api.deepseek.com.
| Opción | Modelo o identificador | Qué ofrece |
|---|---|---|
| Pesos oficiales de OCR 2 | deepseek-ai/DeepSeek-OCR-2 | OCR especializado y reconstrucción de documentos en infraestructura propia |
| Pesos oficiales originales | deepseek-ai/DeepSeek-OCR | Compresión óptica, varios modos de resolución y reproducción del trabajo de 2025 |
| Vision API alojada | deepseek-flash | Análisis general de texto e imágenes a través de DeepSeek API |
| Demo o API de terceros | Depende del proveedor | Interfaz administrada, con precios, privacidad y límites propios |
deepseek-flash puede leer texto de capturas y analizar imágenes, pero es un producto diferente. No debe presentarse como una versión alojada de DeepSeek-OCR 2 ni recibir sus benchmarks, prompts especializados o licencias por asociación.
También debes revisar con cuidado cualquier sitio llamado “DeepSeek OCR Online”. El nombre del dominio o de la herramienta no demuestra que pertenezca a DeepSeek. Comprueba el responsable del servicio, dónde procesa los documentos, cuánto tiempo los conserva y qué modelo utiliza realmente.
Cómo funciona el DeepEncoder original
DeepSeek-OCR se diseñó para representar visualmente una página con muchos menos tokens que los que ocuparía su texto completo. Los autores denominan a esta idea Contexts Optical Compression.
Su DeepEncoder combina tres elementos:
- Un componente SAM-base de aproximadamente 80M de parámetros para percibir la imagen.
- Un componente CLIP-large de unos 300M para modelar conocimiento visual global.
- Un compresor de tokens que conecta ambos componentes y reduce la representación visual.
El artículo describe DeepEncoder con unos 380M de parámetros. Después, un decodificador DeepSeek MoE de 3B reconstruye el texto, activando aproximadamente 570M parámetros durante la inferencia.
El objetivo no es comprimir un archivo ZIP ni reducir directamente el tamaño del PDF. La compresión ocurre en la representación interna: la página se transforma en una cantidad limitada de visual tokens que el decodificador utiliza para generar texto y estructura.
Qué cambia con DeepEncoder V2
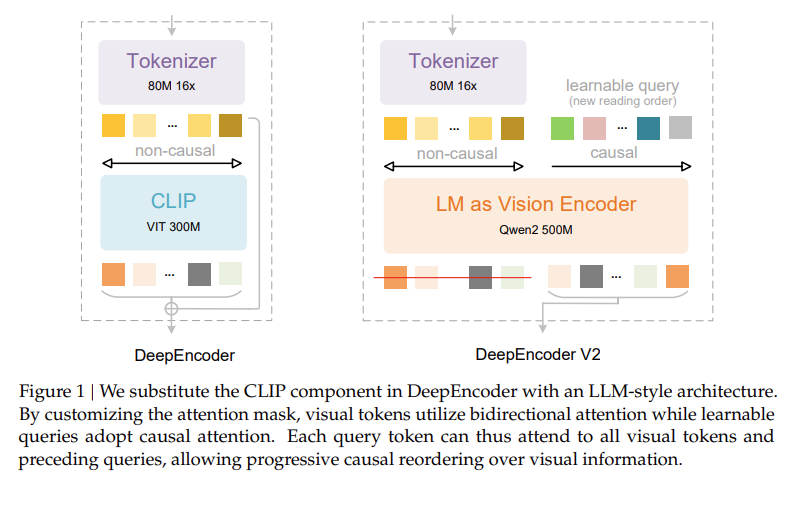
DeepSeek-OCR 2 conserva el enfoque general y el decodificador MoE, pero sustituye el componente CLIP del codificador por una arquitectura de estilo LLM inicializada a partir de Qwen2-0.5B.
DeepEncoder V2 aplica dos patrones de atención:
- Atención bidireccional para los tokens visuales: cada token puede relacionarse con el resto de la imagen.
- Atención causal para las consultas aprendibles: cada consulta puede revisar todos los tokens visuales y las consultas anteriores.
El número de consultas causales coincide con el número de tokens visuales. Solo las salidas de esas consultas se envían al decodificador. La intención es reorganizar la información de acuerdo con el contenido y el diseño de la página antes de generar la transcripción.
Esto puede ser útil en documentos que no siguen un recorrido simple de arriba abajo, como páginas con varias columnas, tablas, pies de figura, encabezados laterales o bloques superpuestos. Aun así, no significa que el modelo “vea como una persona” ni que reconstruya correctamente cualquier diseño.
Qué puede extraer DeepSeek-OCR 2
El modelo puede utilizarse para más que una transcripción lineal. El resultado depende del prompt, la resolución, los recortes y la calidad de la página.
| Tarea | Salida esperada | Qué debes revisar |
|---|---|---|
| OCR simple | Texto sin intentar reconstruir todo el diseño | Nombres, números, acentos y saltos de línea |
| Documento a Markdown | Títulos, párrafos, listas, tablas y fórmulas en una estructura textual | Jerarquía, columnas, celdas combinadas y orden de lectura |
| Grounding | Texto asociado con referencias y coordenadas | Que las cajas correspondan al elemento correcto |
| Tablas | Estructura de filas y columnas | Encabezados, totales, columnas desplazadas y celdas vacías |
| Fórmulas | Representación textual o matemática | Símbolos, índices, fracciones y signos similares |
| Diseño complejo | Orden lógico de bloques y secciones | Columnas, notas laterales, pies y elementos flotantes |
| Figuras | Descripción o análisis solicitado mediante el prompt adecuado | No confundir descripción con extracción exacta de datos |
La reconstrucción de Markdown no conserva necesariamente todas las propiedades del documento original. Puede perder colores, tipografías, enlaces internos, campos interactivos, capas, comentarios, metadatos o detalles exactos de maquetación.
Imágenes y PDF: qué recibe realmente el modelo
El ejemplo directo de Transformers recibe una imagen mediante image_file. El repositorio también incluye un script para procesar PDF, pero eso no significa que el núcleo del modelo interprete el archivo PDF binario como una modalidad separada.
En un flujo de PDF, el proceso práctico suele ser:
- Abrir el PDF y comprobar si ya contiene texto digital seleccionable.
- Renderizar cada página que necesite OCR como una imagen.
- Enviar cada imagen al modelo con el prompt elegido.
- Guardar el texto o Markdown junto con el número de página.
- Registrar páginas fallidas, vacías o truncadas.
- Unir los resultados sin perder el orden original.
- Revisar manualmente nombres, cifras, tablas y fórmulas.
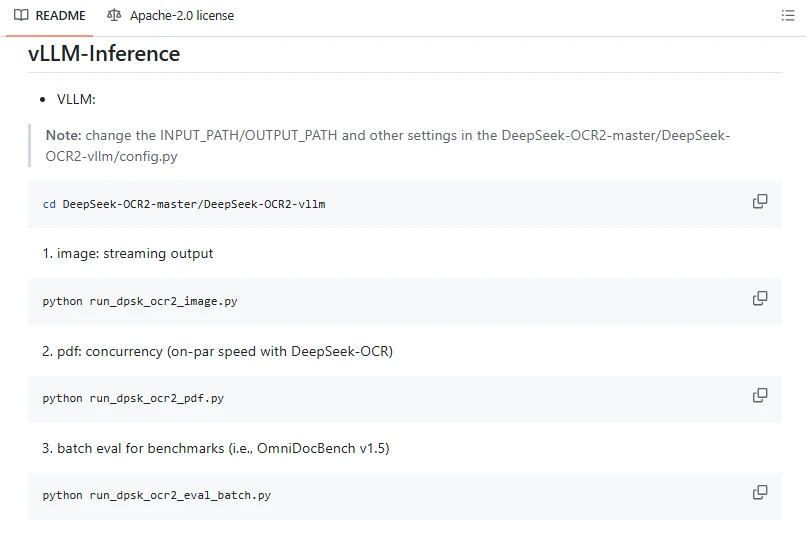
El repositorio de OCR 2 incluye el script run_dpsk_ocr2_pdf.py para procesamiento concurrente de PDF. Antes de utilizarlo, configura correctamente las rutas de entrada y salida en el archivo correspondiente.
Si el PDF contiene texto digital correcto, extraer esa capa suele ser más rápido y preciso que aplicar OCR. Reserva el reconocimiento visual para escaneos, fotografías, texto incrustado en imágenes o documentos cuya capa textual esté dañada.
Los archivos protegidos, corruptos, extremadamente grandes o con contenido activo requieren una etapa de validación anterior. Procesa documentos no confiables en un entorno aislado y limita el número de páginas, el tamaño y el tiempo de ejecución.
Prompts oficiales para texto y Markdown
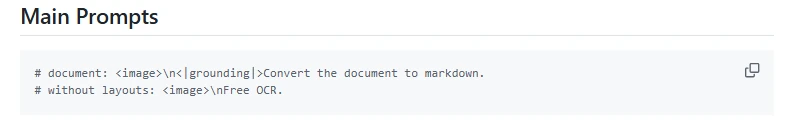
El repositorio oficial muestra dos instrucciones principales. La primera busca texto sin reconstrucción detallada del diseño:
<image>
Free OCR.
La segunda activa grounding y solicita una conversión del documento a Markdown:
<image>
<|grounding|>Convert the document to markdown.
Con grounding, la salida puede incluir etiquetas como:
<|ref|>title<|/ref|>
<|det|>[[330, 198, 558, 230]]<|/det|>
<|ref|> identifica el tipo o referencia del elemento, mientras <|det|> representa sus coordenadas. Estas etiquetas son útiles cuando una aplicación necesita relacionar el texto extraído con una zona concreta de la página.
No traduzcas automáticamente el prompt al español antes de comprobar el resultado. Las instrucciones publicadas fueron las utilizadas por los autores y constituyen el punto de partida más reproducible.
Cómo instalar DeepSeek-OCR 2
El repositorio oficial documenta un entorno probado con Python 3.12.9, CUDA 11.8, PyTorch 2.6.0 y FlashAttention 2.7.3. Es una configuración de referencia, no una promesa de compatibilidad con cualquier sistema.
Para crear el entorno base:
git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git
cd DeepSeek-OCR-2

conda create -n deepseek-ocr2 python=3.12.9 -y
conda activate deepseek-ocr2

pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
  --index-url https://download.pytorch.org/whl/cu118

pip install -r requirements.txt
pip install flash-attn==2.7.3 --no-build-isolation
La instalación de FlashAttention requiere un entorno de compilación compatible. Si tu versión de CUDA, compilador o PyTorch es diferente, no sustituyas versiones al azar: consulta los requisitos del repositorio y de cada paquete.
Ejemplo con Transformers
El siguiente ejemplo reproduce la ruta de inferencia publicada para una imagen. Debes cambiar las rutas por archivos de tu entorno:
import os
from pathlib import Path

import torch
from transformers import AutoModel, AutoTokenizer


MODEL_ID = "deepseek-ai/DeepSeek-OCR-2"
IMAGE_PATH = Path("documento.jpg")
OUTPUT_DIR = Path("salida_ocr")

if not IMAGE_PATH.is_file():
    raise FileNotFoundError(f"No se encontró la imagen: {IMAGE_PATH}")

if not torch.cuda.is_available():
    raise RuntimeError(
        "Este ejemplo oficial requiere una GPU NVIDIA compatible con CUDA."
    )

OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
os.environ["CUDA_VISIBLE_DEVICES"] = "0"

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID,
    trust_remote_code=True,
)

model = AutoModel.from_pretrained(
    MODEL_ID,
    _attn_implementation="flash_attention_2",
    trust_remote_code=True,
    use_safetensors=True,
)

model = model.eval().cuda().to(torch.bfloat16)

prompt = (
    "<image>\n"
    "<|grounding|>Convert the document to markdown. "
)

result = model.infer(
    tokenizer,
    prompt=prompt,
    image_file=str(IMAGE_PATH),
    output_path=str(OUTPUT_DIR),
    base_size=1024,
    image_size=768,
    crop_mode=True,
    save_results=True,
)

print(result)
trust_remote_code=True permite ejecutar código personalizado descargado con el modelo. Revisa los archivos del repositorio antes de utilizarlos, limita quién puede modificar la dependencia y fija una revisión o commit concreto en entornos de producción.
Este ejemplo está basado en las instrucciones oficiales, pero no se ejecutó como parte de este artículo. Debes probarlo con tu combinación de GPU, controlador, CUDA, PyTorch y documentos.
Cómo servir OCR 2 con vLLM
vLLM incluye actualmente soporte para las arquitecturas de DeepSeek-OCR y DeepSeek-OCR-2. Su receta oficial utiliza un procesador de logits específico para reducir repeticiones y mejorar la generación de tablas y Markdown.
vllm serve deepseek-ai/DeepSeek-OCR-2 \
  --logits_processors \
  vllm.model_executor.models.deepseek_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching \
  --mm-processor-cache-gb 0
Este comando levanta un servidor local compatible con parte del formato de OpenAI. No crea un endpoint de DeepSeek Cloud ni aplica automáticamente autenticación, límites de uso, cifrado, registros seguros o control de acceso.
Antes de exponerlo en una red:
- Añade autenticación y autorización.
- Limita tamaño, resolución y cantidad de imágenes.
- Configura tiempos de espera y cuotas.
- Evita registrar documentos o resultados sensibles.
- Aísla el proceso de archivos no confiables.
- Registra la versión exacta del modelo y de vLLM.
- Valida que la solicitud multimodal envíe realmente una imagen, no solo texto.
Los ejemplos genéricos de completado de texto que aparecen en algunas interfaces de Hugging Face sirven para mostrar el servidor, pero no demuestran un flujo de OCR completo. Una solicitud real debe incluir la imagen en un campo multimodal compatible.
Resultados de OmniDocBench v1.5
Los autores evaluaron OCR 2 principalmente con OmniDocBench v1.5. El conjunto contiene 1,355 páginas distribuidas en nueve categorías, entre ellas revistas, artículos académicos y reportes de investigación. Sus idiomas son chino e inglés.
| Métrica publicada | DeepSeek-OCR con 9 recortes | DeepSeek-OCR 2 | Interpretación |
|---|---|---|---|
| Máximo de tokens visuales | 1,156 | 1,120 | Menor es más eficiente si la calidad se mantiene |
| Puntuación global | 87.36 | 91.09 | Mayor es mejor |
| Edit Distance de texto | 0.073 | 0.048 | Menor es mejor |
| CDM de fórmulas | 84.14 | 90.31 | Mayor es mejor |
| TEDS de tablas | 85.25 | 87.75 | Mayor es mejor |
| Edit Distance del orden de lectura | 0.085 | 0.057 | Menor es mejor |
| Edit Distance global de parsing | 0.129 | 0.100 | Menor es mejor |
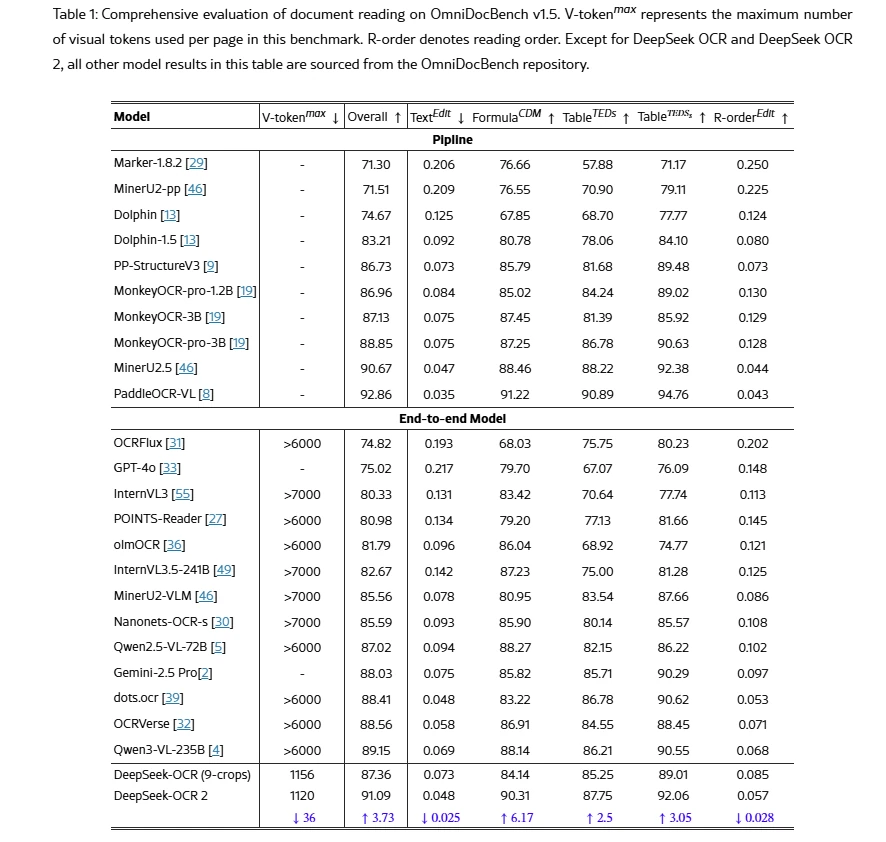
La diferencia entre 91.09 y 87.36 es de 3.73 puntos en la puntuación agregada de ese benchmark. No significa que OCR 2 sea un 3.73% más preciso en cualquier factura, libro, fotografía o idioma.
Estos resultados fueron publicados por los propios autores bajo su configuración. Antes de adoptar el modelo, reproduce una evaluación con tus documentos, resolución, runtime, prompts y reglas de posprocesamiento.
La debilidad en páginas de periódico
El artículo reconoce que OCR 2 mantiene dificultades con periódicos densos en texto. En esta categoría, la Edit Distance del texto fue superior a 0.13.
Los autores relacionan esta debilidad con el límite de tokens visuales y con una cantidad insuficiente de ejemplos de periódicos en los datos de entrenamiento. Por ello, una puntuación global alta no elimina la necesidad de probar por separado documentos con columnas estrechas, texto pequeño y diseños muy densos.
Por qué el 97% del primer OCR no es una precisión general
El artículo de DeepSeek-OCR original informa una precisión de decodificación cercana al 97% cuando el número de tokens de texto es inferior a diez veces el número de tokens visuales.
Ese dato procede de una prueba concreta:
- Se utilizó la parte inglesa del benchmark Fox.
- La evaluación incluyó 100 páginas con entre 600 y 1,300 tokens de texto.
- Se probaron principalmente los modos Tiny y Small.
- El prompt fue
<image>\nFree OCR.. - La precisión disminuyó al aumentar la compresión.
El mismo trabajo informa valores cercanos al 60% con una compresión aproximada de 20 veces. Por tanto, “97%” no es una tasa universal para PDF, tablas, escritura a mano, documentos españoles o cualquier resolución.
El reporte de más de 200,000 páginas por día en una GPU A100 de 40 GB también corresponde al entorno de producción descrito por los autores. No es una promesa de rendimiento para otra GPU, configuración o tipo de documento.
¿DeepSeek OCR funciona bien en español?
Las fichas de Hugging Face etiquetan ambos modelos como multilingües, pero las fuentes oficiales consultadas no publican una puntuación específica para español latinoamericano. OmniDocBench v1.5 evalúa principalmente páginas en chino e inglés.
La única forma fiable de decidir si sirve para tu proyecto es construir una muestra representativa en español. Incluye:
- La letra ñ y palabras con acentos.
- Signos de interrogación y exclamación de apertura.
- Nombres de personas, empresas y ciudades.
- Fechas con diferentes formatos.
- Monedas, separadores decimales y porcentajes.
- Números de factura, folios e identificadores.
- Documentos con español e inglés mezclados.
- Tablas con texto pequeño.
- Páginas con dos o más columnas.
- Fotografías inclinadas o con bajo contraste.
No corrijas automáticamente las palabras desconocidas antes de comparar el resultado. Un sistema OCR puede convertir un nombre válido en una palabra más común y producir un texto lingüísticamente correcto, pero documentalmente falso.
¿Reconoce escritura a mano?
No existe en las fuentes principales revisadas una evaluación oficial suficiente para afirmar que DeepSeek-OCR 2 ofrece una precisión alta y generalizable en escritura a mano.
Evalúa por separado:
- Texto impreso.
- Notas manuscritas claras.
- Escritura cursiva.
- Firmas.
- Sellos.
- Formularios completados a mano.
- Fotografías con desenfoque.
- Páginas manchadas, dobladas o deformadas.
Un buen resultado en una publicación académica o en un PDF digital no predice necesariamente el comportamiento con una receta, una firma o una nota escrita rápidamente.
Requisitos de hardware
DeepSeek no publica un mínimo universal de VRAM o RAM para OCR 2. La ficha oficial muestra pesos BF16 y un archivo principal cercano a 6.78 GB, pero los pesos son solo una parte del consumo total.
También utilizan memoria:
- El codificador visual.
- Las activaciones.
- FlashAttention.
- Los recortes dinámicos.
- La resolución de entrada.
- El lote de páginas.
- El runtime.
- La caché y los buffers.
- El resultado generado.
La configuración del repositorio fue probada con GPU NVIDIA, CUDA 11.8 y BF16. Esto no demuestra que exista un mínimo único ni que cualquier tarjeta con memoria ligeramente superior al archivo de pesos pueda ejecutar el modelo de manera estable.
Una cuantización comunitaria puede reducir memoria, pero también puede modificar la precisión de caracteres, tablas, fórmulas y orden de lectura. No la presentes como equivalente a los pesos oficiales sin una evaluación comparativa.
Cómo comprobar la calidad del OCR
No proceses un archivo completo de documentos antes de completar una prueba piloto. Una evaluación práctica puede seguir este flujo:
- Selecciona páginas representativas de cada tipo de documento.
- Crea una transcripción manual confiable para una parte de la muestra.
- Ejecuta OCR 2 con una configuración registrada.
- Compara el texto carácter por carácter y palabra por palabra.
- Revisa nombres, fechas, cantidades y unidades.
- Comprueba el orden entre columnas y bloques.
- Revisa celdas, encabezados y totales de las tablas.
- Compara símbolos, fracciones e índices de las fórmulas.
- Marca páginas vacías, incompletas, repetidas o truncadas.
- Prueba una segunda resolución o configuración de recortes.
- Registra errores por categoría de documento.
| Métrica | Qué mide | Cuándo resulta útil |
|---|---|---|
| CER | Porcentaje de errores a nivel de caracteres | Nombres, códigos, cifras y transcripción literal |
| WER | Errores a nivel de palabras | Texto corrido y búsqueda documental |
| Edit Distance | Cambios necesarios para igualar la referencia | Comparaciones generales de texto y orden |
| TEDS | Similitud estructural de tablas | Filas, columnas y jerarquía de celdas |
| CDM | Similitud de contenido matemático | Fórmulas y expresiones |
| Métrica de orden de lectura | Secuencia de bloques recuperados | Columnas, revistas, reportes y documentos complejos |
No todas las métricas son necesarias para cada proyecto. Una aplicación que busca contratos necesita priorizar nombres, fechas y cláusulas; una que procesa artículos científicos puede necesitar tablas, fórmulas y referencias.
Cuándo elegir OCR 2, el original u otra solución
| Necesidad | Opción a evaluar | Motivo |
|---|---|---|
| Proyecto nuevo con diseños complejos | DeepSeek-OCR 2 | Mejoras publicadas en orden de lectura, texto, tablas y fórmulas |
| Reproducir el trabajo de compresión óptica | DeepSeek-OCR original | Incluye los modos Tiny, Small, Base, Large y Gundam del estudio de 2025 |
| Pipeline existente validado con el original | Mantener y comparar antes de migrar | Una actualización puede modificar formato y errores |
| Texto impreso sencillo en CPU | OCR tradicional | Puede requerir menos infraestructura y ser más predecible |
| Análisis de imágenes mediante una API administrada | DeepSeek Vision u otro proveedor verificado | Evita alojar el modelo, pero es un producto y costo distintos |
| Documentos sensibles | Despliegue controlado y auditado | Permite definir almacenamiento, acceso, registros y retención |
No elijas por una puntuación aislada. Compara también consumo de memoria, estabilidad, tiempo por página, porcentaje de páginas que necesitan revisión y facilidad de integrar la salida en tu sistema.
Licencias y costo real
El repositorio y los pesos del DeepSeek-OCR original se publican bajo MIT. DeepSeek-OCR 2 utiliza Apache License 2.0. Ambas licencias pueden permitir usos amplios, incluido el comercial, pero mantienen obligaciones y no sustituyen una revisión jurídica para cada producto.
Revisa:
- El texto completo de la licencia del modelo.
- Los avisos que deban conservarse.
- El archivo NOTICE cuando corresponda.
- Las licencias de Transformers, vLLM, FlashAttention y otras dependencias.
- Los derechos sobre los documentos procesados.
- Las condiciones de cualquier proveedor de nube.
- Las licencias de una cuantización o conversión comunitaria.
Descargar los pesos no genera una tarifa por solicitud de DeepSeek, pero el sistema no es “gratis” en sentido operativo. Debes considerar GPU, almacenamiento, transferencia, mantenimiento, monitoreo, seguridad y revisión humana.
Privacidad y seguridad de los documentos
Ejecutar OCR 2 localmente puede darte más control que enviar documentos a una herramienta pública, pero “local” no significa automáticamente “privado”. La privacidad depende de toda la infraestructura.
Revisa si existen:
- Registros que guardan rutas, texto o imágenes.
- Telemetría de herramientas.
- Backups automáticos.
- Almacenamiento temporal sin cifrar.
- Usuarios con acceso excesivo.
- Endpoints accesibles desde Internet.
- Políticas de retención indefinida.
No envíes documentos de identidad, datos bancarios, historias clínicas, contratos confidenciales o archivos de clientes a una demo pública sin revisar quién opera el servicio y qué hace con los datos.
Para archivos no confiables, utiliza un entorno aislado, aplica límites de tamaño y páginas, analiza el archivo antes de renderizarlo y elimina los temporales conforme a una política definida.
Preguntas frecuentes sobre DeepSeek OCR
¿Cuál es la versión más reciente?
DeepSeek-OCR 2 es la versión oficial más reciente encontrada en los repositorios, fichas de modelo e índice de investigación de DeepSeek. No se encontró un DeepSeek-OCR 3 oficial hasta la fecha de verificación.
¿OCR 2 reemplaza completamente al modelo original?
No. OCR 2 ofrece una arquitectura más reciente y mejores resultados publicados en OmniDocBench v1.5, pero el original sigue disponible para reproducción, investigación, compatibilidad con pipelines existentes y comparación de modos de resolución.
¿Existe un modelo DeepSeek OCR en la API oficial?
No en la lista actual. La API alojada muestra deepseek-flash y deepseek-v4-pro. Los ID deepseek-ai/DeepSeek-OCR y deepseek-ai/DeepSeek-OCR-2 pertenecen a Hugging Face y se utilizan para desplegar los pesos.
¿Se puede usar OCR 2 desde DeepSeek Chat?
No debes asumirlo. Subir una imagen al chat puede utilizar el modelo visual alojado de DeepSeek, pero eso no demuestra que la petición se procese mediante el checkpoint DeepSeek-OCR-2.
¿Puede convertir PDF a Markdown?
Sí mediante el pipeline incluido en el repositorio: las páginas del PDF se procesan visualmente y los resultados pueden reunirse en Markdown. Esto no implica conservar todas las propiedades, enlaces, metadatos o elementos interactivos del PDF original.
¿Funciona con documentos en español?
El modelo está etiquetado como multilingüe y puede extraer texto español, pero no existe en las fuentes oficiales revisadas una puntuación específica para español latinoamericano. Debes evaluarlo con una muestra propia.
¿Reconoce escritura a mano?
Puede producir resultados con algunas muestras, pero no hay datos oficiales suficientes para prometer una precisión alta en escritura manuscrita. Evalúa notas, formularios y firmas por separado.
¿Cuánta VRAM necesita?
DeepSeek no publica un mínimo universal. El consumo cambia con la precisión, la resolución, los recortes, el lote, el runtime y la configuración. El tamaño del archivo de pesos no equivale a la VRAM total necesaria.
¿Existe una versión oficial para Ollama?
Las fuentes oficiales revisadas se centran en Transformers y vLLM. Una versión de Ollama, GGUF o LM Studio debe tratarse como conversión comunitaria hasta comprobar el publicador, el formato, la licencia, el soporte de imágenes y el prompt template.
¿DeepSeek OCR es gratis para uso comercial?
Los pesos no tienen una tarifa por solicitud de DeepSeek y se publican bajo MIT en el modelo original y Apache 2.0 en OCR 2. Sin embargo, existen costos de infraestructura y obligaciones de licencia, privacidad y derechos sobre los documentos.
Qué versión conviene utilizar
Para un proyecto nuevo, comienza evaluando DeepSeek-OCR 2 con una muestra pequeña y representativa. Su DeepEncoder V2 mejora el orden de lectura y obtiene mejores resultados publicados en texto, tablas y fórmulas bajo el benchmark utilizado por los autores.
Mantén el modelo original cuando necesites reproducir la investigación de compresión óptica, conservar compatibilidad con un pipeline validado o comparar los modos de resolución publicados en 2025. En ambos casos, el criterio final debe ser la tasa de errores de tus propios documentos, no una cifra aislada del artículo.
Fuentes consultadas
- Repositorio oficial de DeepSeek-OCR.
- Repositorio oficial de DeepSeek-OCR-2.
- Model Card oficial de DeepSeek-OCR.
- Model Card oficial de DeepSeek-OCR-2.
- DeepSeek-OCR: Contexts Optical Compression.
- DeepSeek-OCR 2: Visual Causal Flow.
- Documentación de DeepSeek-OCR-2 en Transformers.
- Modelos compatibles con vLLM.
- Receta oficial de vLLM para DeepSeek-OCR-2.
- Lista de modelos de DeepSeek API.
- Documentación oficial de DeepSeek Vision.